Grok 4.6 hadir di API xAI pada 12 Agustus 2026 dengan judul besar yang sudah lazim dan satu catatan kaki yang jauh lebih penting. Model ini memiliki jendela konteks 500.000 token, dengan tarif US$2 per satu juta token input dan US$6 per satu juta token output. Namun, saat sebuah prompt mencapai 200.000 token, tarifnya menjadi dua kali lipat untuk seluruh permintaan. Bagi usaha kecil yang membandingkan penyedia AI, rincian itu lebih penting daripada grafik benchmark pada hari peluncuran.
Rilis ini ditujukan untuk coding, pekerjaan agen, dan tugas berbasis pengetahuan. Ia mungkin menjadi pilihan baru yang berguna untuk alur kerja bervolume tinggi dan batas tugas yang jelas. Ini bukan alasan untuk memindahkan data pelanggan, mengganti proses yang berjalan baik, atau memilih penyedia hanya dari satu skor. Berikut alasan praktis untuk mengujinya, beserta pemeriksaan yang perlu dilakukan sebelum migrasi.
Artikel ini memisahkan hal yang dikonfirmasi dokumentasi xAI sendiri dari laporan benchmark independen, dan menandai angka yang belum terverifikasi secara independen. Tujuannya adalah proses pengambilan keputusan yang bisa dipakai, bukan putusan tentang lab AI mana yang menang dalam siklus rilis minggu ini.
🚀 Apa yang sebenarnya dirilis xAI
xAI, yang kini tampil dalam dokumentasinya sebagai SpaceXAI, mencantumkan grok-4.6 sebagai model terdepannya untuk coding, tugas agen, dan pekerjaan berbasis pengetahuan. Halaman model resmi menyebut ia menerima input teks dan gambar lalu menghasilkan output teks. Ia mendukung function calling dan structured outputs, dua kemampuan yang relevan saat bisnis menghubungkan model ke katalog, helpdesk, spreadsheet, atau alat internal.
Halaman model juga mencantumkan empat pengaturan reasoning: low, medium, high, dan xhigh. Ini mengingatkan bahwa “Grok 4.6” bukan satu profil biaya atau latensi yang tetap. Tim yang mengujinya perlu mencatat pengaturan reasoning dalam setiap perbandingan. Peningkatan yang terlihat pada model bisa saja sebenarnya perubahan pengaturan.
Liputan independen menggambarkan 4.6 sebagai penyempurnaan dari basis sekitar 1,5 triliun parameter yang sama dengan Grok 4.5, dengan peningkatan yang dikaitkan pada post-training. Itu konteks yang berguna, tetapi berasal dari pelaporan, bukan spesifikasi produk. Fakta operasional yang dapat diandalkan adalah input, jenis output, batas konteks, harga, dan kemampuan API yang didokumentasikan.
Bagi peritel, agensi, atau usaha jasa di Indonesia, rilis ini hanya relevan bila menyelesaikan pekerjaan yang jelas. Contohnya membuat draf awal deskripsi produk dari fakta yang sudah disetujui, mengelompokkan tiket untuk peninjau manusia, mengekstrak kolom dari dokumen yang diberikan, atau membuat serah-terima terstruktur bagi karyawan. “Mencoba model terbaru” bukan deskripsi pekerjaan.
Penting juga untuk menyebut apa yang berubah dan apa yang tidak. Jendela konteks, function calling, dan structured output sudah tersedia di Grok 4.5. Hal yang dijual xAI dengan 4.6 adalah post-training yang lebih baik untuk coding dan tugas agen dengan harga API utama yang sama. Itu klaim yang lebih sempit daripada “model frontier baru”, dan sebaiknya diuji sesempit itu. Bisnis yang tidak menjalankan coding atau alur kerja agen multilangkah mungkin mendapati peningkatan ini kurang berpengaruh pada pekerjaan sehari-hari.
Akses konsumen tersedia berdampingan dengan API. Liputan independen mencatat Grok masih tersedia melalui X dan Grok Bot dalam paket konsumen bertingkat, dengan paket SuperGrok Heavy tertinggi sekitar US$300 per bulan. Itu pembelian yang berbeda dari API pengembang yang dibahas artikel ini. Bisnis yang menilai integrasi API tidak boleh mencampurkan keduanya saat membandingkan biaya internal.
💰 Kartu harga memiliki dua tarif berbeda
Tarif standar adalah US$2 per satu juta token input, US$0,50 per satu juta token input yang di-cache, dan US$6 per satu juta token output. Tarif ini berlaku di bawah 200.000 token prompt. Pada 200.000 token atau lebih, halaman harga xAI mencantumkan US$4 untuk input, US$1 untuk input cache, dan US$12 untuk output per satu juta token.
Sekilas, dua tingkatan itu terlihat seperti ini:
- Standar (di bawah 200.000 token): US$2,00 input, US$0,50 input cache, US$6,00 output per juta token.
- Long context (200.000 token atau lebih): US$4,00 input, US$1,00 input cache, US$12,00 output per juta token, berlaku untuk seluruh permintaan.
- Input cache pada tingkat standar naik dari US$0,30 di era Grok 4.5 menjadi US$0,50 di Grok 4.6, rincian yang tidak muncul dalam tajuk peluncuran.
Ambang itu bukan tambahan kecil untuk token yang melewati batas. Menurut tabel resmi, tarif long context berlaku pada permintaan tersebut. Tim yang mengirim prompt 201.000 token tidak boleh menganggarkannya sebagai permintaan 200.000 token ditambah 1.000 token mahal. Sejak awal, ia masuk kolom long context.
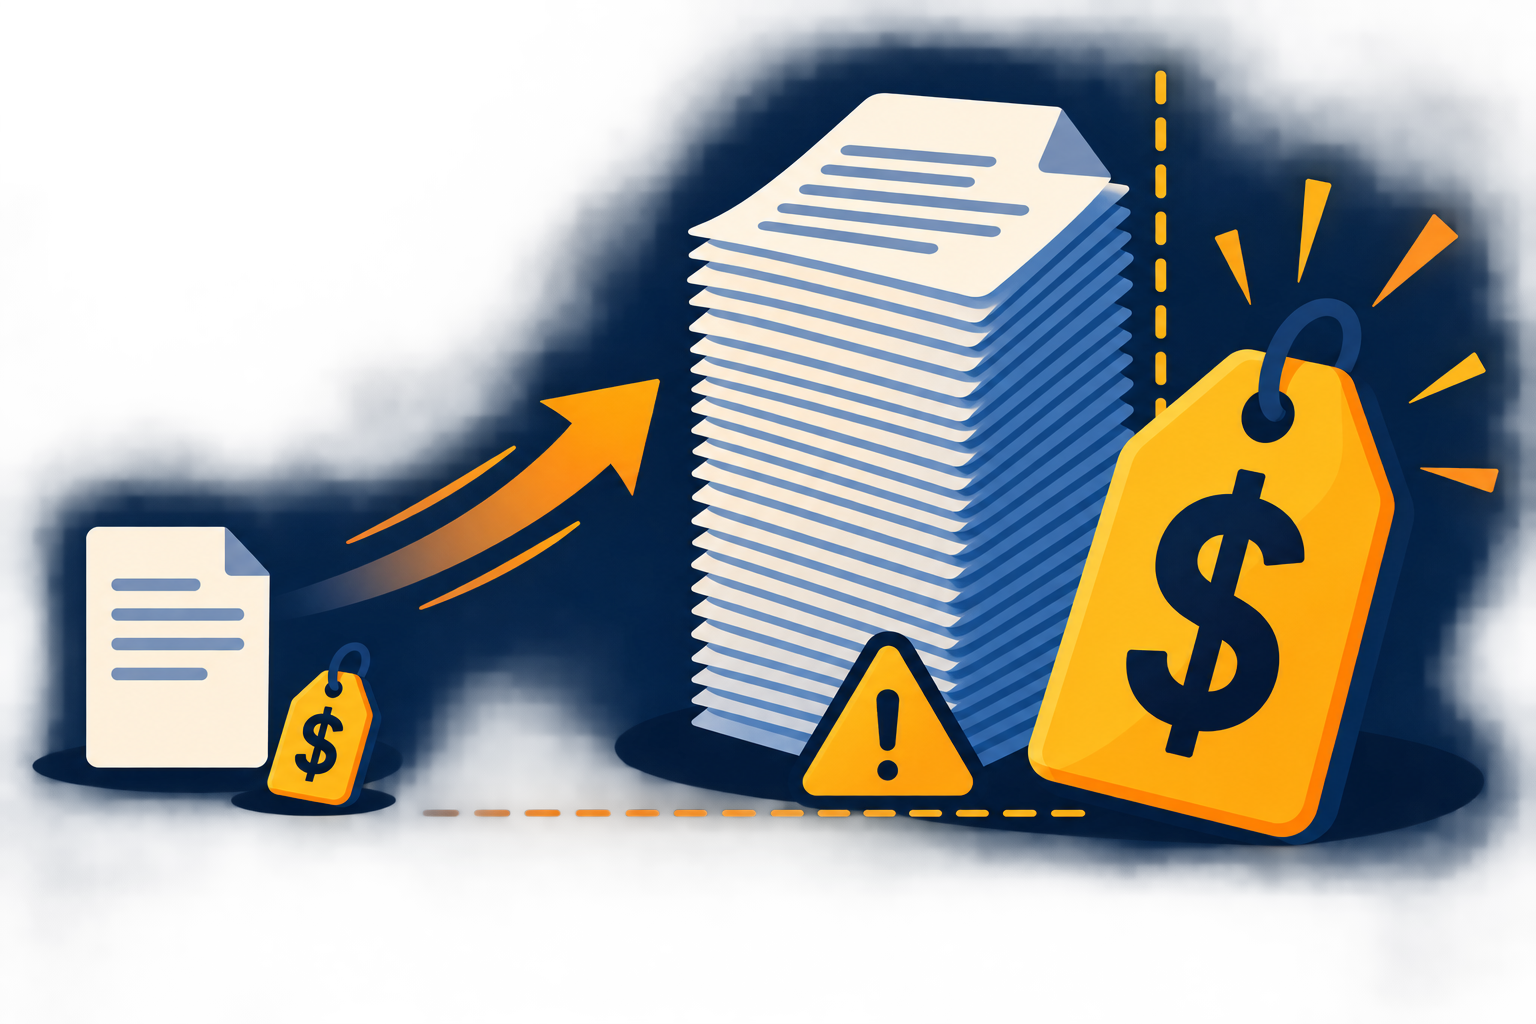
Struktur itu menghasilkan satu aturan operasional sederhana: pisahkan dan pendekkan prompt bisnis biasa. Masukkan kasus pelanggan saat ini, kebijakan yang disetujui, dan catatan pesanan yang relevan. Jangan melampirkan seluruh arsip hanya karena lebih mudah. Ringkas bahan yang stabil, ambil hanya bagian yang diperlukan, lalu ukur jumlah token sebelum menambahkan berkas besar.
Ada rincian perbandingan lain. Tabel xAI mencantumkan input cache US$0,50 per juta token untuk Grok 4.6, sedangkan analisis independen mencatat Grok 4.5 mencantumkan US$0,30 pada tingkat standarnya. Prompt cache masih bisa mengurangi biaya dibanding input tanpa cache, tetapi “harga utama yang sama” tidak berarti setiap alur kerja memiliki biaya yang sama setelah pembaruan.
Disiplin yang berguna adalah memodelkan tagihan bulanan yang nyata sebelum memutuskan apa pun. Ambil sampel prompt selama seminggu, perkirakan jumlah token masing-masing, lalu pisahkan ke kelompok standar dan long context. Kalikan dengan tarif yang tertera, termasuk input cache bila alur kerja menggunakan kembali system prompt atau dokumen referensi yang tetap. Bandingkan totalnya dengan tagihan penyedia saat ini untuk sampel yang sama. Harga utama yang tampak 60 persen lebih murah dari pesaing masih bisa kalah bila bentuk prompt Anda dihitung, terutama bila alur kerja sering mendekati batas 200.000 token.
🗂️ Jendela 500.000 token adalah kapasitas, bukan alur kerja
Jendela konteks 500.000 token cukup besar untuk menggoda tim memasukkan manual, kontrak, katalog produk, dan riwayat percakapan dalam satu permintaan. Kapasitas model tidak membuktikan bahwa tindakan itu aman, akurat, hemat, atau sesuai kebijakan data bisnis.
Mulailah dari relevansi. Pelanggan yang bertanya apakah kemeja biru tersedia membutuhkan stok terkini dan kebijakan jawaban yang disetujui. Ia tidak membutuhkan setiap pesanan dari tahun lalu. Staf yang memeriksa satu klausul kontrak membutuhkan perjanjian yang ditandatangani serta rute eskalasi yang jelas, bukan tumpukan kontrak tidak terkait.
Kemudian pertimbangkan pengendalian sumber. Prompt panjang dapat memuat daftar harga usang, instruksi yang disalin dari vendor, atau teks bermusuhan yang tertanam dalam dokumen. Model tidak boleh menganggap setiap kalimat dalam berkas yang dipasok sebagai perintah. Pisahkan aturan sistem, tandai materi eksternal sebagai data rujukan, dan wajibkan keputusan manusia untuk pengembalian dana, pembayaran, perubahan akun, komitmen hukum, atau publikasi.
Terakhir, hitung harganya. Long context bernilai bila alternatifnya adalah pemeriksaan manual yang mahal dan tugasnya memiliki batas jelas. Ia boros bila langkah retrieval dapat memilih sepuluh paragraf yang relevan. Ambang 200.000 token membuat perbedaan ini terlihat pada desain prompt sekaligus tagihan.
Ada pertimbangan keempat yang kerap dilewati: latensi. Prompt lebih besar membutuhkan waktu lebih lama untuk diproses bahkan ketika model menanganinya dengan benar. Pelanggan yang menunggu balasan chat akan menyadari jawaban lambat sama seperti jawaban salah. Bila alur kerja memerlukan respons cepat, misalnya handoff live chat atau pertanyaan di titik penjualan, menjaga prompt tetap kecil bukan hanya lebih hemat. Itu dapat menentukan apakah alat benar-benar dipakai staf atau ditinggalkan diam-diam.
📊 Benchmark adalah petunjuk, bukan surat perintah pembelian
Dua analisis peluncuran independen melaporkan skor Artificial Analysis Intelligence Index 61 untuk Grok 4.6, kira-kira setara dengan GPT-5.6 Sol dan di atas Grok 4.5. Keduanya juga melaporkan hasil kuat pada CursorBench, FrontierCode, AA-Briefcase, dan APEX-Agents, sambil mencatat GPT-5.6 Sol tetap unggul di DeepSWE serta beberapa pekerjaan coding skala repositori.
Angka itu dapat membantu tim teknik menentukan apa yang patut diuji. Angka itu tidak memberi tahu apakah salon akan menangani pertanyaan pelanggan Indonesia dengan baik, apakah data produk peritel bersih, atau apakah integrasinya gagal dengan aman. Tugas benchmark, akses alat, prompt, pengaturan reasoning, dan aturan penilaian tidak selalu identik antarvendor.
Baca perbandingan xAI dan rangkuman pihak ketiga dengan disiplin yang sama seperti membaca studi kasus pemasok. Tanyakan apa yang diukur, siapa yang menjalankan, konfigurasi apa yang dipakai, dan apakah tugasnya serupa dengan tugas Anda. Model dapat tampil baik pada benchmark coding lalu tetap membuat kesalahan yang tak dapat diterima saat diminta menyimpulkan status pesanan dari data tidak lengkap.
Hasil berguna dari membaca benchmark adalah hipotesis uji. Contohnya: “Model ini mungkin mengurangi jumlah tool call yang dibutuhkan untuk mengelompokkan tiket dukungan masuk.” Pernyataan itu dapat diukur pada sampel lalu dibandingkan dengan proses sekarang. “Model ini frontier-level” tidak dapat diuji sebagai keputusan bisnis.
Perlakukan angka 61 seperti memperlakukan tingkat pengiriman yang dilaporkan sendiri oleh pemasok. Angka itu menyatakan vendor yakin performanya baik pada kumpulan uji tertentu. Angka itu tidak menjelaskan yang terjadi pada sepuluh persen kasus ketika pelanggan menulis dengan bahasa gaul, mengirim foto barang rusak yang buram, atau menggabungkan dua pertanyaan tidak terkait. Kasus-kasus tepi inilah yang sering menghabiskan waktu usaha kecil, dan tidak ada papan peringkat publik yang mengukurnya untuk Anda.
🛡️ Efisiensi agen membutuhkan pagar pengaman
Sebuah analisis sekunder melaporkan Grok 4.6 menyelesaikan alur kerja agen multilangkah yang kompleks dalam sekitar 53 langkah, dibanding sekitar 103 langkah untuk Claude Opus 5 pada perbandingan yang dikutip. Angka itu menarik karena langkah lebih sedikit dapat berarti tool call lebih sedikit, latensi lebih rendah, dan biaya lebih kecil. Tetap saja, itu hasil benchmark yang dilaporkan, bukan jaminan tingkat layanan.
Bagi bisnis, langkah lebih sedikit hanya baik bila setiap langkah dapat diamati dan dibatalkan. Agen yang memeriksa stok, membuat draf balasan, dan membuka tiket dapat berguna. Agen yang mengirim diskon, mengubah alamat pelanggan, atau menandai pembayaran sebagai diterima tanpa pemeriksaan manusia dapat menciptakan masalah mahal dengan langkah yang lebih sedikit.
Atur izin berdasarkan akibat, bukan kecerdasan model yang tampak. Biarkan model mengusulkan balasan. Biarkan ia mengambil spesifikasi produk. Wajibkan orang atau aturan deterministik yang eksplisit sebelum ia mengirim pesan, mengubah catatan, menerbitkan kredit, atau memicu pengiriman. Catat versi prompt, tool call, sumber yang dipakai, output, keputusan peninjau, dan tindakan akhir.
Di sini tim kecil justru memiliki kelebihan. Mereka dapat memulai dengan satu antrean sempit, meninjau setiap hasil, dan segera tahu apakah otomasi mengurangi pekerjaan nyata. Janji besar tentang agen otonom kurang berguna dibanding tabel yang menunjukkan tugas mana yang diizinkan, mana yang hanya boleh ditinjau, dan mana yang tetap dilarang.
Buat tabel itu sebelum menjalankan satu prompt produksi pun. Daftarkan setiap tindakan yang mungkin dilakukan agen: membaca catatan produk, membuat draf balasan, mencari dokumen, memberi tag tiket, mengirim pesan, memperbarui kolom basis data, menerapkan diskon, atau menandai pesanan terpenuhi. Tandai setiap tindakan sebagai otomatis, wajib ditinjau, atau dilarang. Tinjau ulang tabel setiap bulan. Godaan untuk diam-diam memindahkan tindakan wajib-tinjau menjadi otomatis adalah cara agen dengan langkah lebih sedikit berubah dari kemudahan menjadi insiden.
⚖️ Perbandingan nyata dilakukan per alur kerja
Harga peluncuran membuat Grok 4.6 menarik untuk bentuk pekerjaan tertentu: banyak prompt di bawah ambang long context, volume output yang berarti, dan tugas ketika pemahaman teks atau gambar ditambah structured output menghemat waktu staf. Bisnis harus membandingkannya dengan alat saat ini dalam kondisi yang sama, bukan dengan papan peringkat daring yang umum.
Buat scorecard dengan lima kolom: akurasi terhadap materi sumber yang disetujui, biaya per tugas selesai, waktu sampai hasil siap pakai, tingkat koreksi peninjau, dan jenis kegagalan. Tambahkan kolom keenam untuk kebutuhan penanganan data. Bila tim tidak dapat menjelaskan data apa yang keluar dari sistemnya dan siapa yang dapat mengaksesnya, pilot belum siap.
Untuk coding, gunakan repositori nonproduksi atau tiket terisolasi. Untuk dukungan pelanggan, gunakan percakapan historis yang sudah dianonimkan setelah detail sensitif dihapus. Untuk pekerjaan dokumen, pilih berkas yang sudah diperiksa secara manual. Setiap sampel membutuhkan hasil yang diharapkan sebelum model berjalan. Tanpa itu, jawaban yang halus dapat keliru dianggap benar.
Jangan lupa mengukur waktu peninjauan manusia sebagai bagian dari biaya total, bukan hanya biaya token. Sebuah draf yang tampak cepat dan murah pada kertas dapat menjadi lambat bila peninjau harus membaca ulang tiga kali lebih banyak teks untuk menemukan satu kesalahan kecil. Waktu staf adalah biaya nyata, dan pilot yang baik mencatatnya sejak hari pertama, bukan sebagai catatan tambahan di akhir laporan.
Pemenang dapat berbeda di setiap alur kerja. Model lebih murah mungkin terbaik untuk mengelompokkan pesan rutin. Model lebih mumpuni mungkin layak untuk tugas teknis yang jarang dengan peninjau senior. Proses berbasis aturan biasa mungkin tetap lebih baik untuk perhitungan harga dan status pembayaran.
Jangan lewatkan baris membosankan pada scorecard. Model yang membuat caption sedikit lebih lancar tetapi membutuhkan waktu integrasi dua kali lebih lama, memerlukan akun tagihan baru, atau memperumit kebijakan retensi data tidak otomatis layak diadopsi. Timbang biaya pindah, termasuk pelatihan ulang staf dan risiko menjalankan dua sistem paralel saat transisi, terhadap peningkatan yang terukur. Keuntungan sederhana yang terintegrasi baik lebih berharga daripada demo mengesankan yang gagal saat menghadapi antrean dukungan nyata.
🇮🇩 UMKM Indonesia sebaiknya memulai dari tugas yang membosankan
Pilot pertama harus cukup berguna untuk berarti dan cukup membosankan untuk diaudit. Kandidat yang baik termasuk mengubah fakta produk yang telah disetujui menjadi beberapa draf caption, mengekstrak kolom dari formulir standar, mengelompokkan prospek, membuat ringkasan internal percakapan pelanggan, atau menyarankan balasan yang wajib disetujui karyawan.
Hindari memakai pilot pertama untuk nasihat hukum publik, klaim kesehatan, perlakuan pajak final, konfirmasi pembayaran, otorisasi pengembalian dana, keputusan perekrutan, atau bot live yang berbicara sebagai bisnis tanpa peninjauan. Ini bukan sekadar “berisiko tinggi” secara teori. Jawaban salah dapat menghabiskan uang, membuka data pelanggan, atau merusak kepercayaan.
Tulis kontrak input. Ia dapat sesederhana ini: gunakan hanya fakta produk yang diberikan; bila fakta belum tersedia, katakan belum tersedia; jangan pernah menjanjikan stok, pengiriman, diskon, atau penerimaan pembayaran; kembalikan JSON dengan draft, missingFacts, dan needsHumanReview. Kontrak terstruktur memberi tim sesuatu yang konkret untuk diperiksa.
Kualitas bahasa Indonesia layak mendapat set uji sendiri. Masukkan bentuk bahasa pelanggan yang sopan, singkatan, istilah produk campuran Indonesia-Inggris, dan pertanyaan yang tidak memiliki detail penting. Periksa apakah model meminta informasi yang belum ada alih-alih mengarangnya. Perilaku itu sering lebih bernilai daripada draf awal yang terdengar lancar.
Uji juga variasi daerah dan platform. Pesan melalui WhatsApp sering berbeda dari formulir situs: lebih pendek, lebih banyak singkatan, sesekali berupa transkrip catatan suara, dan satu pertanyaan kerap dipecah menjadi beberapa pesan. Bila set evaluasi hanya berisi pertanyaan bersih dalam satu pesan, hasil pilot akan terlihat lebih baik daripada performa alat ketika benar-benar bertemu pelanggan.
🧪 Jalankan pilot empat minggu sebelum mengganti standar
Minggu pertama adalah persiapan. Pilih satu alur kerja, buat 50 sampai 100 kasus uji yang mewakili tetapi aman, tetapkan hasil yang diharapkan, dan putuskan siapa yang meninjau setiap output. Tetapkan batas belanja dan ukuran prompt maksimum. Nonaktifkan tindakan produksi.
Minggu kedua adalah perbandingan buta. Jalankan kasus yang sama melalui proses saat ini dan Grok 4.6. Bila memungkinkan, peninjau menilai akurasi dan kelengkapan sebelum mengetahui alat mana yang membuat hasil. Catat koreksi, jangan hanya mengandalkan kesan pada akhir minggu.
Minggu ketiga adalah bantuan live yang terkendali. Gunakan model untuk persentase kecil draf internal atau kasus review-only. Ukur waktu penyelesaian, tingkat koreksi, pemakaian token, dan output tak terduga. Hentikan uji bila ia membuka data, mengarang fakta material, melewati aturan yang ditetapkan, atau menyebabkan kesalahan yang sampai ke pelanggan.
Minggu keempat adalah keputusan. Lanjutkan hanya jika model memenuhi ambang akurasi, menghemat cukup waktu setelah peninjauan, tetap sesuai anggaran, dan memiliki rute rollback terdokumentasi. Publikasikan set instruksi, batas izin, penanggung jawab peninjau, dan perkiraan biaya bulanan. Bila dokumen itu terasa berlebihan, tugas tersebut mungkin belum siap diotomasi.
Simpan catatan pilot setelah keputusan dibuat, baik hasilnya adopsi maupun penolakan. Pilot yang ditolak bukan kerja sia-sia. Ia menjadi alasan terdokumentasi agar evaluasi yang sama tidak diulang ketika model baru berikutnya datang dengan janji serupa. Simpan kasus uji, penilaian, dan memo keputusan di tempat yang dapat ditemukan seluruh tim, bukan hanya di kepala orang yang menjalankan uji.
🔄 Pergantian versi mengubah keputusan migrasi
Grok 4.6 dirilis di tengah pembaruan model yang cepat. Liputan independen menyebut xAI memberi sinyal arsitektur Grok 4.7 yang lebih besar dalam beberapa minggu, dengan Grok 5 ditargetkan sebelum akhir 2026. Perlakukan peta jalan itu sebagai sinyal, bukan jaminan. Peta jalan produk dapat berubah.
Implikasi praktisnya jelas: jangan membangun alur kerja penting di atas asumsi yang belum diuji tentang satu versi model. Kendalikan prompt, kasus evaluasi, kebijakan, dan antarmuka alat Anda sendiri. Gunakan abstraksi penyedia bila masuk akal, tetapi jangan menambah kerumitan rekayasa hanya untuk mengejar setiap rilis.
Pembaruan vendor dapat mengubah perilaku model, harga, batas laju, dukungan alat, atau ketersediaan. Simpan set kasus uji dasar dan jalankan kembali sebelum mengubah standar produksi. Kunci versi bila API mengizinkan. Pantau tagihan setelah setiap rilis. Pertahankan jalur manual untuk pelanggan dan staf.
Aset bisnis bukan nama model. Asetnya adalah alur kerja yang sudah diuji, data sumber yang bersih, proses peninjauan staf, dan kemampuan menghentikan otomasi tanpa menurunkan mutu layanan.
✅ Keputusan yang dapat dibuat bisnis hari ini
Grok 4.6 layak dievaluasi secara terbatas bila Anda memiliki alur kerja berbasis teks atau dibantu alat yang dapat diukur, ditinjau, dan sebagian besar berada di bawah ambang long context. Harga resmi dan kapasitas 500.000 token menjadikannya kandidat yang kredibel untuk evaluasi tersebut. Kemampuan yang dipublikasikan tidak menghapus kebutuhan tata kelola data dan akuntabilitas manusia.
Jangan beralih hanya karena grafik menyebut model ini setara dengan pesaing. Beralihlah hanya ketika perbandingan terkendali menunjukkan hasil lebih baik untuk tugas Anda pada biaya yang diketahui, dengan jawaban jelas atas apa yang terjadi ketika model salah.
Itulah disiplin yang perlu dipertahankan dalam setiap siklus rilis cepat. Uji satu alur kerja kecil yang dapat dibatalkan. Catat buktinya. Tempatkan manusia pada titik keputusan yang menyangkut uang, identitas, janji, dan pelanggan. Lalu pilih model yang benar-benar membuktikan nilainya bagi bisnis.
Ini tidak memerlukan tim besar atau departemen teknis. Toko dengan tiga staf dapat menjalankan pilot empat minggu memakai spreadsheet, dokumen bersama berisi kasus uji, dan satu orang yang bertanggung jawab meninjau setiap output selama percobaan. Yang dibutuhkan adalah kesabaran untuk menjalani bulan pertama yang lebih lambat demi keputusan yang dapat dipertanggungjawabkan, bukan pindah cepat berdasarkan tajuk hari peluncuran yang akan digantikan tajuk lain beberapa minggu kemudian.
Catatan penutup yang perlu diingat setiap kali ada rilis model baru: kecepatan siklus rilis di industri ini bukan alasan untuk terburu-buru mengambil keputusan bisnis. Justru sebaliknya. Semakin cepat model berganti, semakin penting memiliki proses evaluasi internal yang stabil dan dapat diulang, sehingga setiap rilis baru dinilai dengan standar yang sama, bukan dengan antusiasme yang berbeda-beda tergantung seberapa ramai pemberitaannya minggu itu.
Sumber: halaman model Grok 4.6, halaman harga, dan catatan rilis resmi SpaceXAI/xAI; Netalith, “Grok 4.6: Release Date, Pricing, Benchmarks, and What's Actually New” (13 Agustus 2026); AIToolsRecap, “AI News August 14 2026: Grok 4.6 Launches” (14 Agustus 2026). Angka benchmark yang dilaporkan penyedia ditandai demikian dalam teks.