Klaim kecepatan terbaru OpenAI mudah disalahartikan. Perusahaan ini tidak merilis model baru bernama Ultrafast. OpenAI membuka pratinjau terbatas untuk tingkatan layanan API baru yang menyajikan model GPT-5.6 Sol yang sudah ada hingga 14 kali lebih cepat daripada pemrosesan Standard, dengan klaim puncak 750 token keluaran per detik. Tingkatan ini ditenagai perangkat keras Cerebras.
Hal itu penting karena jeda respons sering menjadi penghalang ketika demo AI hendak dipakai dalam proses bisnis. Balasan yang datang tiga puluh detik kemudian masih berguna untuk menulis deskripsi produk. Namun, jeda tersebut jauh lebih sulit diterima dalam percakapan pelanggan, alur suara langsung, atau proses pemecahan masalah ketika langkah berikutnya bergantung pada jawaban sebelumnya. Meski begitu, pengumuman ini bukan berarti toko lingkungan bisa menyalakan ChatGPT yang lebih cepat hari ini. Aksesnya terbatas, produknya hanya tersedia melalui API, dan pertanyaan yang relevan bukan apakah angka 14x terdengar mengesankan. Pertanyaannya adalah apakah sebuah alur kerja benar-benar kehilangan uang atau kepercayaan pelanggan saat menunggu.
🚀 Apa yang sebenarnya diumumkan OpenAI
OpenAI mengumumkan pratinjau Ultrafast pada 13 Agustus 2026. Penawaran ini disebut sebagai tingkatan layanan untuk GPT-5.6 Sol, bukan keluarga model terpisah. Angka utama yang disampaikan adalah “hingga 14x lebih cepat” daripada pemrosesan Standard dan hingga 750 token yang dihasilkan setiap detik. Itu adalah klaim performa, bukan janji bahwa setiap prompt akan selesai dalam seperempat belas dari waktu biasanya.
Respons model terdiri dari beberapa tahap. Sistem harus menerima permintaan, memproses masukan, mulai menghasilkan jawaban, memanggil alat yang dibutuhkan aplikasi, lalu mengirim jawaban lengkap kembali kepada pengguna. Angka kecepatan terutama bisa mengacu pada pembuatan token setelah model mulai menjawab. Angka itu tidak menghapus jeda jaringan, integrasi CRM yang lambat, kueri basis data, aturan persetujuan manusia, atau pelanggan yang belum memberikan nomor pesanan.
OpenAI mengatakan pratinjau ini ditujukan untuk beban kerja ketika latensi memiliki nilai operasional langsung. Contohnya mencakup respons insiden, agen pengembang, dukungan pelanggan dan suara, riset finansial, deteksi penipuan, serta e-commerce. Contoh tersebut berguna untuk memikirkan kemungkinan penggunaan, tetapi bukan studi kasus yang membuktikan hasil untuk semua usaha.
Laporan The Next Web memberi konteks yang layak diperhatikan. Penguji awal yang disebut dalam pratinjau, termasuk Jane Street, Podium, Basis, dan Rogo, menggambarkan perubahan itu sebagai perubahan kualitatif, bukan sekadar tambahan kecil. Salah satu penguji dikutip mengatakan kecepatan “completely changes the call experience for complex work” dan membuka “synchronous experiences for users that were previously limited by intelligence.” Nilai cenderung muncul bukan pada semua tugas, melainkan saat seseorang sedang menunggu di sisi lain, seperti panggilan, chat, atau sesi pemecahan masalah aktif.
Karena itu, pembacaan awal yang tepat harus sempit. Model yang sudah mampu kini dapat disajikan jauh lebih cepat kepada kelompok pelanggan API yang terbatas. Ini bukan fitur baru untuk pengguna biasa aplikasi ChatGPT. Ini bukan jaminan bahwa agen dapat mengambil keputusan aman tanpa pengawasan. Ini juga bukan pengumuman ketersediaan umum untuk Indonesia. Pemilik usaha perlu memisahkan tiga klaim yang gampang tercampur: model menjadi lebih cerdas, model menjadi lebih murah, dan model menjadi lebih cepat. Pengumuman ini hanya benar-benar membuat klaim ketiga.
⚡ Mengapa kecepatan mengubah bentuk alur kerja AI
Bagi orang yang menulis email sesekali, menunggu memang menjengkelkan tetapi masih dapat ditoleransi. Pada sistem dengan banyak langkah, waktu tunggu menumpuk. Bayangkan asisten dukungan yang harus membaca pesan pelanggan, mengambil kebijakan, memeriksa stok, menyusun balasan, memeriksa nada balasan itu, lalu menawarkan pengalihan ke manusia. Jeda pada setiap tahap membuat seluruh percakapan terasa ragu-ragu meski tiap jawaban sebenarnya akurat.
Itulah sebabnya kecepatan mulai menjadi sifat produk, bukan catatan kecil dalam benchmark. Jawaban lebih cepat dapat membuat pelanggan bertahan di percakapan. Operator dapat mencoba beberapa pilihan kata saat kampanye masih disusun. Tim teknis bisa memeriksa log insiden yang baru muncul sebelum konteksnya menjadi basi. Semua itu tidak membutuhkan kecerdasan ajaib. Yang dibutuhkan adalah bagian lain dari alur kerja siap menerima respons pada kecepatan tersebut.
Ada sisi sebaliknya. Jawaban salah yang cepat akan lebih cepat pula sampai kepada pelanggan. Agen cepat dapat membuat tiket ganda, menyebut harga lama, atau menjanjikan pengembalian dana yang tidak pernah disetujui staf. Nilai dari latensi rendah meningkat bila usaha punya sumber data jelas, izin yang dibatasi, dan jalur aman menuju manusia. Tanpa itu, pembuatan jawaban yang lebih cepat hanya mempercepat proses yang memang sudah berantakan.
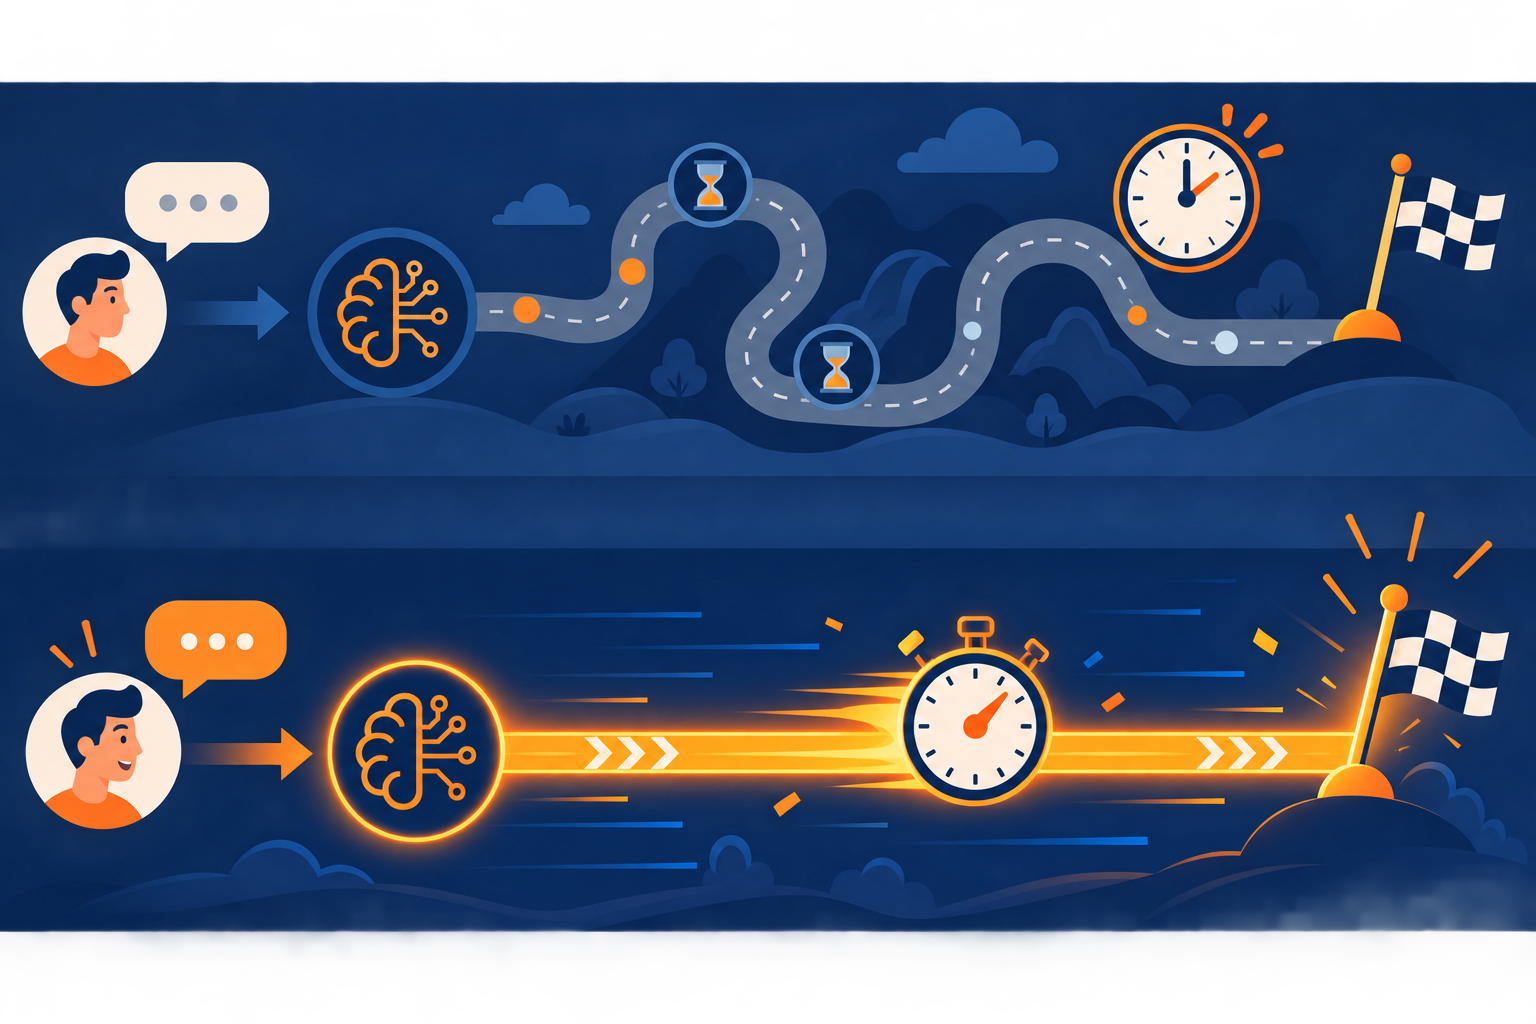
Uji yang berguna adalah mengukur keseluruhan tugas. Catat waktu dari pesan pertama pelanggan sampai hasil yang benar dan disetujui. Jika manusia masih memerlukan sepuluh menit untuk memeriksa pembayaran, mengatur pengiriman, atau menyelesaikan pengecualian, balasan model dalam hitungan kurang dari satu detik tidak akan mengubah proses itu menjadi layanan instan. Balasan cepat mungkin memperbaiki respons pertama, dan itu tetap dapat bernilai, tetapi itu adalah manfaat yang berbeda.
🖥️ Cerita perangkat keras di balik judul besar
OpenAI menyebut Ultrafast berjalan pada infrastruktur yang disediakan Cerebras. Pada Januari 2026, OpenAI mengumumkan kemitraan Cerebras untuk menambah 750 megawatt komputasi AI berkecepatan tinggi. Pratinjau saat ini merupakan penerapan yang terlihat dari upaya lebih besar tersebut untuk menurunkan latensi inference.
Diskusi publik tentang chip AI sering berfokus pada pelatihan, yaitu proses mahal untuk membuat atau memperbarui model secara besar-besaran. Inference berbeda. Inference adalah pekerjaan berulang menghasilkan jawaban ketika model sudah tersedia. Chat layanan pelanggan, saran kode, asisten suara, dan pencarian produk semuanya menciptakan kebutuhan inference. Bagi usaha yang memakai API, jeda inference adalah jeda yang dirasakan pelanggan.
Cerebras dikenal dengan sistem wafer-scale. Pendekatannya menempatkan komputasi dalam jumlah besar pada satu prosesor seukuran wafer, bukan membagi model ke banyak akselerator konvensional. Keunggulan yang diklaim untuk sebagian tugas inference adalah perpindahan data antarchip lebih sedikit, sehingga waktu tunggu sebelum token berikutnya muncul dapat berkurang. Ini adalah konteks teknis di balik klaim kecepatan OpenAI.
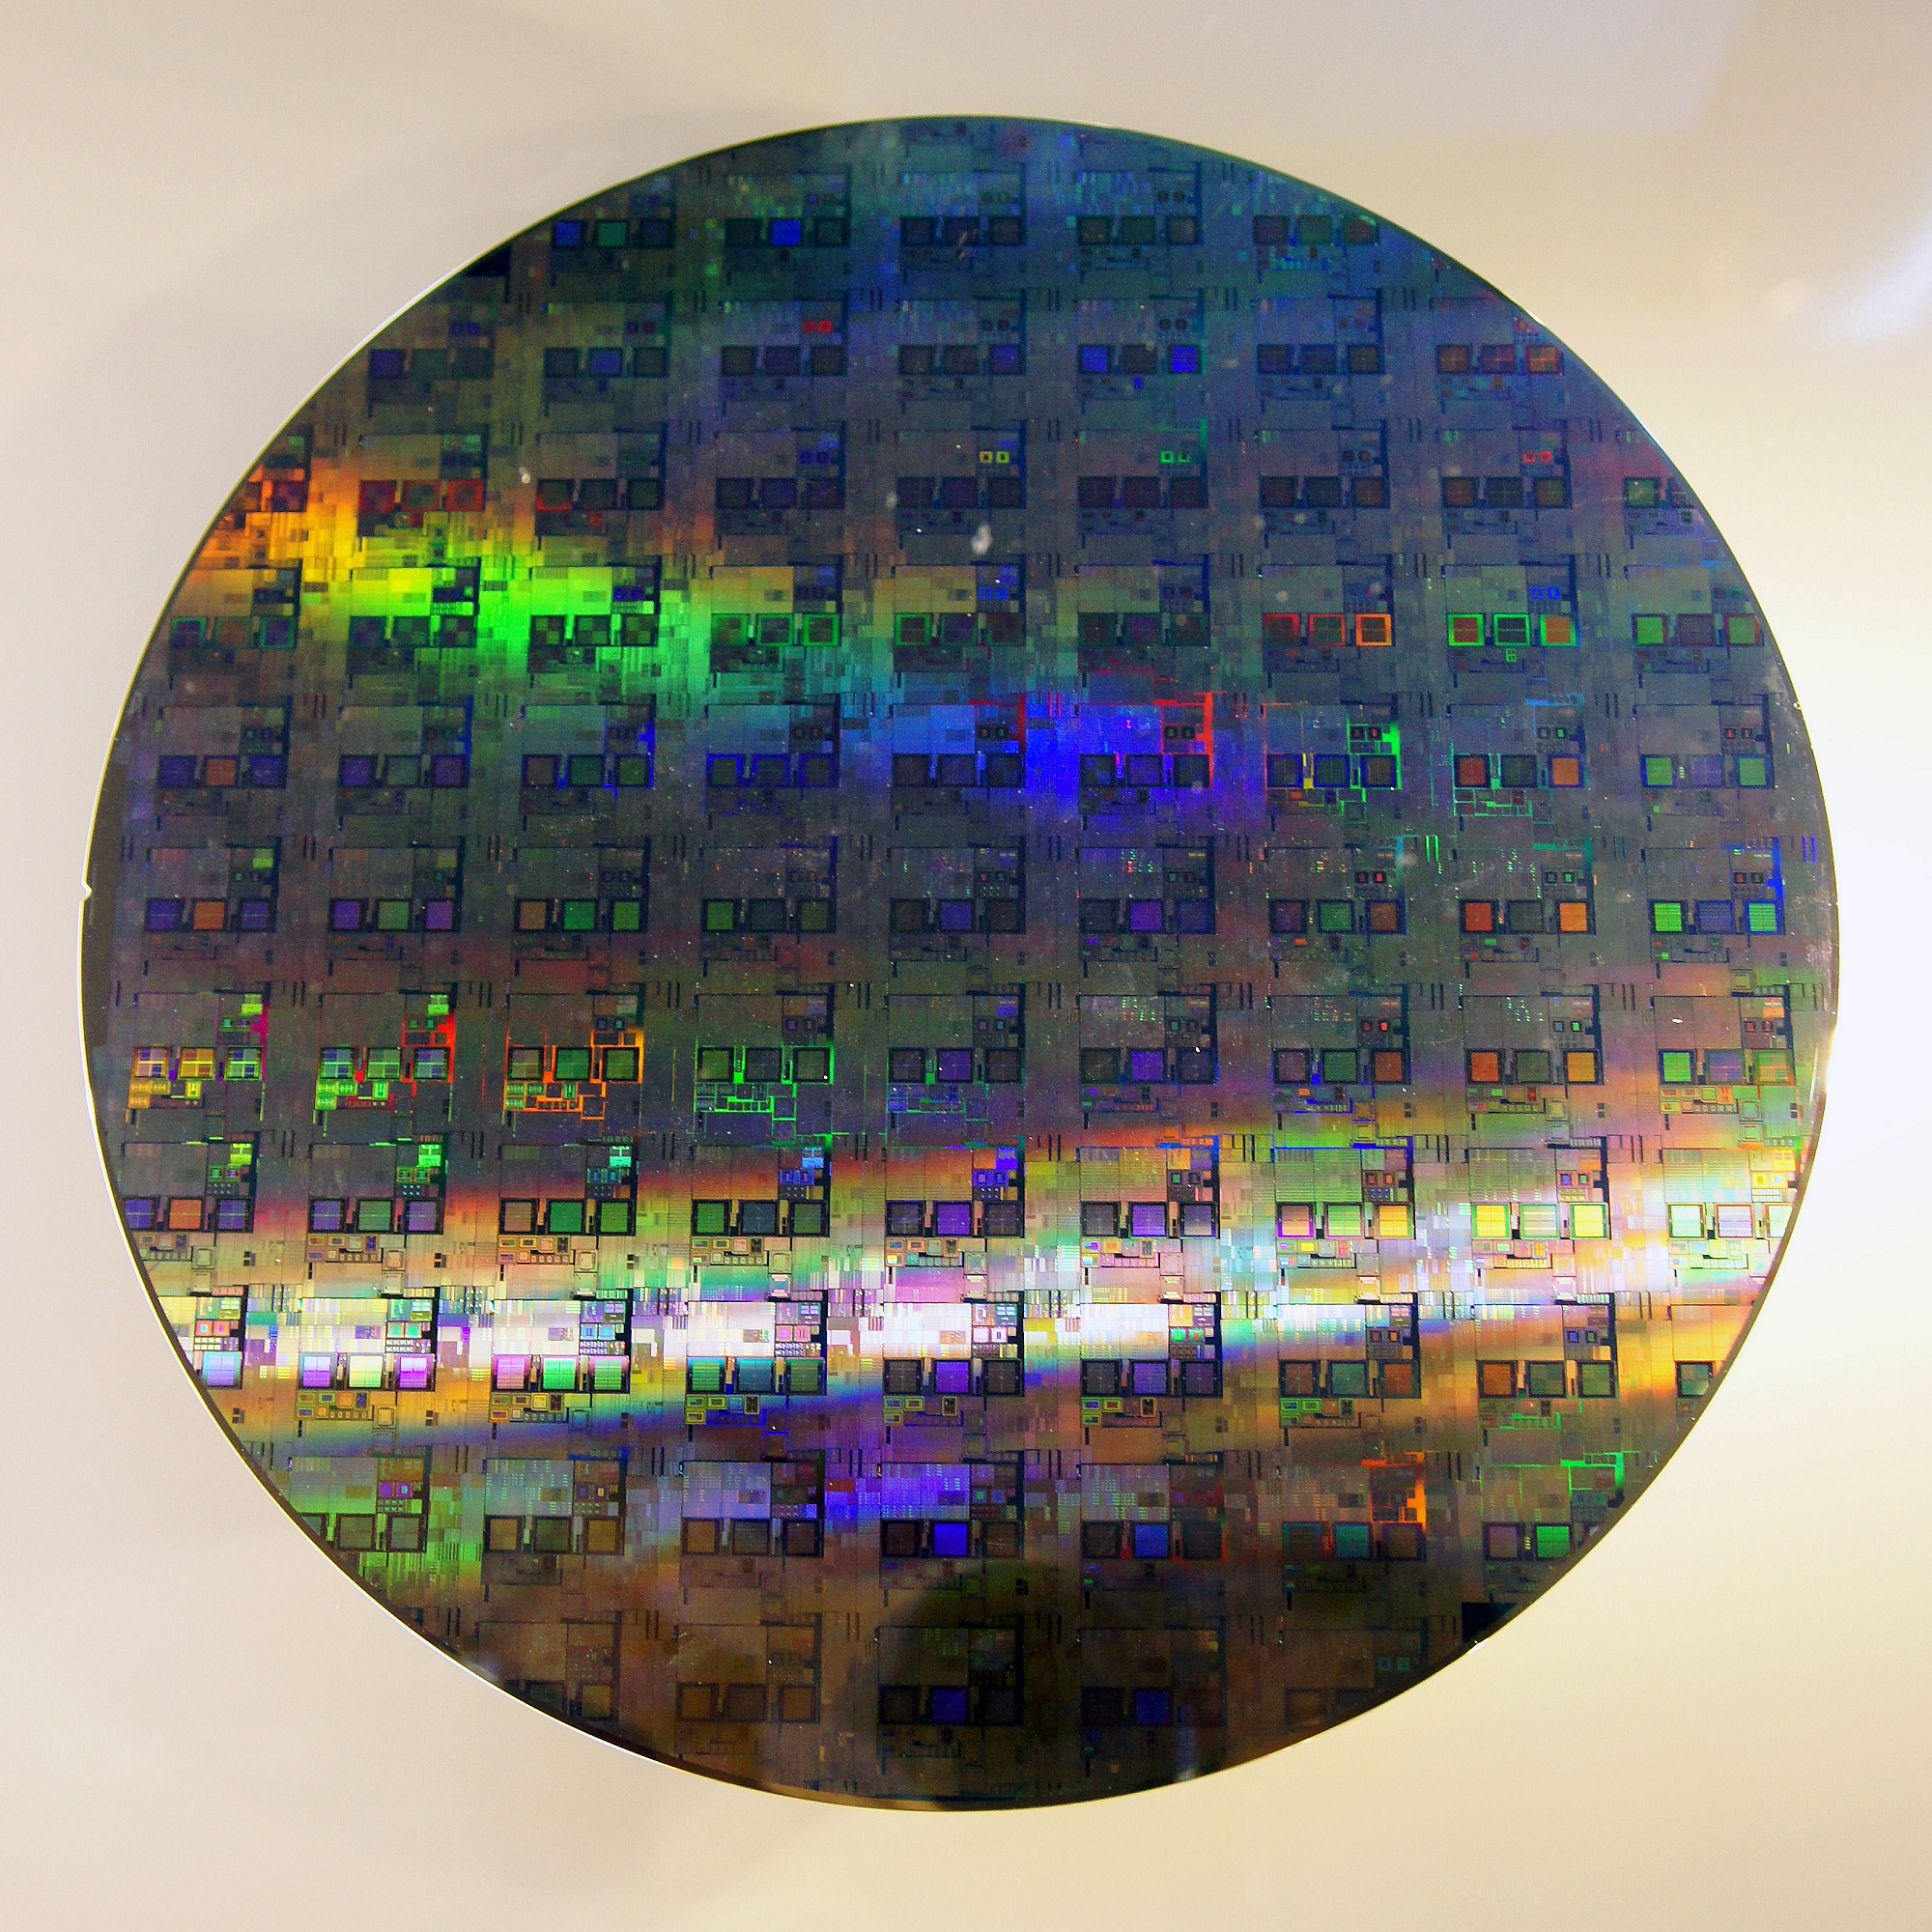
Jangan mengubah berita ini menjadi keputusan belanja perangkat keras untuk usaha kecil. Toko kecil tidak bisa masuk pratinjau dengan membeli chip. OpenAI menjual akses ke tingkatan layanan yang dihosting. Cerita perangkat keras penting karena menjelaskan mengapa sebuah model dapat menjadi lebih cepat tanpa berubah menjadi model berbeda. Cerita ini juga menjelaskan mengapa kapasitas terbatas. Infrastruktur real-time tidak otomatis tak terbatas hanya karena ada halaman API.
🔐 Siapa yang bisa memakai Ultrafast hari ini
Jawabannya memang sengaja terbatas. OpenAI menyatakan tingkatan ini masih berada dalam pratinjau terbatas bagi kelompok kecil pelanggan. Laporan TechCrunch, 9to5Mac, India Today, dan The Next Web sama-sama menyebut proses pendaftaran atau daftar tunggu sembari kapasitas ditambah. Pemilik usaha tidak boleh menyampaikan kepada klien bahwa tingkatan ini tersedia sebelum organisasi mereka menerima konfirmasi akses tertulis dalam akun API sendiri.
Pembatasan itu mengubah tindakan langsung bagi sebagian besar bisnis Indonesia. Tidak ada migrasi praktis yang bisa dijalankan hari ini. Yang bisa dilakukan adalah mendokumentasikan alur kerja. Tentukan di mana respons AI yang lambat sekarang menimbulkan masalah yang terlihat, kumpulkan data dasar selama beberapa minggu, dan tetapkan apa yang dianggap sebagai perbaikan bila akses tersedia kelak.
Usaha yang sudah memanggil API model dapat menyiapkan uji terkendali. Pertahankan prompt, sumber pengetahuan, kebijakan eskalasi, dan antarmuka pengguna yang sama. Ubah hanya tingkatan layanan. Bandingkan jeda token pertama, waktu sampai jawaban selesai, tingkat intervensi manusia, pelanggan yang meninggalkan chat sebelum balasan, dan biaya per percakapan yang berhasil diselesaikan. Tujuannya menemukan dampak bisnis yang berarti, bukan merayakan angka teknis.
Usaha yang hanya memakai aplikasi chat konsumen bahkan memiliki lebih sedikit hal yang perlu diubah. Mereka tidak perlu membangun ulang proses sekitar pratinjau yang belum dapat diakses. Investasi yang lebih baik adalah katalog produk yang akurat, FAQ yang disetujui, jalur serah-terima yang jelas, dan cara menjaga harga serta stok tetap mutakhir. Aset itu tetap berguna dengan model dan penyedia apa pun.
💬 Contoh layanan pelanggan, dengan batas yang jelas
Penjual menerima pertanyaan yang sama setiap hari. Apakah warna ini masih ada? Berapa perkiraan pengiriman? Bisakah ukuran diganti? Apakah harga sudah termasuk ongkir? Asisten cepat dapat menyusun jawaban dari katalog yang dipelihara dan segera meminta informasi yang kurang. Ini dapat membuat chat terasa ditangani bahkan sebelum anggota tim masuk.
Batasnya lebih penting daripada kecepatannya. Asisten tidak seharusnya mengonfirmasi transfer bank, menjanjikan pengiriman sebelum persediaan diperiksa, menyetujui pengembalian di luar kebijakan, atau mengarang diskon. Tugasnya adalah mengenali pertanyaan, mengambil informasi yang disetujui, meminta informasi berikutnya yang diizinkan, dan mengalihkan pengecualian. Bila pembeli mengirim tangkapan layar pembayaran, bisnis tetap memerlukan proses rekonsiliasi yang benar. Respons model yang lancar bukan bukti dana masuk.
Uji yang masuk akal sengaja dibuat membosankan. Pilih satu kategori pertanyaan sempit, misalnya jam buka atau spesifikasi produk. Gunakan teks persis dari sumber yang disetujui. Jalankan dalam rentang waktu tertentu. Minta staf meninjau sampel percakapan. Hentikan jika asisten mulai mengarang fakta atau jika pelanggan mendapat jawaban berbeda untuk pertanyaan yang sama.
Latensi menjadi penting saat balasan cepat sekaligus dapat diandalkan. Respons tiga detik dengan status stok yang benar dapat mengurangi waktu tunggu yang tidak perlu. Respons satu detik dengan status stok kemarin dapat menciptakan masalah lebih besar daripada jeda sepuluh menit.
🎙️ Suara, agen, dan godaan mengotomatisasi terlalu jauh
Contoh OpenAI mencakup alur kerja suara dan agen karena keduanya sangat peka terhadap jeda. Orang cepat menyadari kekosongan dalam percakapan lisan. Agen yang harus memanggil beberapa sistem juga terasa lambat saat setiap langkah perencanaan memunculkan jeda panjang. Inference yang lebih cepat dapat membuat pengalaman itu terasa lebih wajar.
Namun, hal itu tidak otomatis membuatnya aman bagi usaha kecil. Suara menambah risiko kesalahan transkripsi, kebisingan latar, aksen, privasi, dan kemungkinan penelepon salah memahami jawaban otomatis. Agen menambah risiko berbeda: ia bisa melakukan rangkaian tindakan, bukan hanya menghasilkan teks. Izin untuk melihat pesanan, mengubah alamat, menerbitkan pengembalian dana, dan mengubah stok tidak boleh diperlakukan sebagai satu izin hanya karena modelnya cepat.
Tetapkan kewenangan lebih dulu. Asisten boleh membacakan kebijakan pengiriman publik. Ia boleh mengumpulkan nomor pesanan. Ia boleh mengusulkan balasan untuk ditinjau staf. Ia tidak boleh mengubah status pembayaran atau mengirim uang kecuali bisnis telah membangun kontrol eksplisit di sekeliling tindakan itu. Latensi yang lebih rendah tidak menggantikan log audit, akses berbasis peran, atau orang yang bertanggung jawab atas pengecualian.
Bagi banyak tim kecil, agen pertama terbaik bukan agen otonom. Bentuk yang lebih aman adalah alat draf-dan-rutekan: mengelompokkan permintaan, menampilkan catatan yang relevan, mengusulkan balasan, lalu membiarkan tindakan akhir pada operator. Desain seperti ini meraih sebagian manfaat kecepatan tanpa mempertaruhkan usaha pada otomatisasi tanpa pengawasan.
Ada risiko lain yang lebih senyap. Kecepatan dapat membuat proses buruk tampak layak lebih lama dari seharusnya. Jika asisten menjawab seketika tetapi jumlah stoknya salah, pelanggan mungkin sudah bertindak sebelum ada orang menangkap kesalahan. Sistem yang lebih lambat terkadang memberi staf jeda tak sengaja untuk melihat kekeliruan sebelum sampai ke pelanggan. Menghapus jeda itu melalui kecepatan hanya aman bila data dan aturan dasarnya sudah dapat dipercaya.
Pertimbangkan juga siapa yang paling merasakan dampak dari otomatisasi yang tergesa-gesa. Karyawan garis depan biasanya menjadi orang pertama yang menghadapi keluhan bila asisten menjawab salah dengan yakin. Melibatkan mereka dalam menyusun aturan eskalasi, bukan hanya memberi tahu mereka setelah sistem berjalan, membuat batas kewenangan lebih realistis dan lebih mudah dipatuhi dalam praktik sehari-hari.
💰 Biaya, kapasitas, dan pertanyaan harga yang belum terjawab
Pengumuman OpenAI menjelaskan performa dan akses pratinjau, tetapi pemilik usaha tidak boleh menganggap waktu tunggu lebih rendah akan memiliki harga yang sama dengan pemrosesan Standard. Infrastruktur yang lebih cepat dapat membawa premi. Pengumuman Fast Mode Anthropic pada Februari 2026 menjadi pengingat. Perusahaan itu menyebut opsi 2,5x lebih cepatnya lebih mahal dijalankan dan diposisikan untuk pekerjaan mendesak.
Tarif, ketentuan, dan kuota Ultrafast yang tersedia bagi pelanggan tertentu harus diperoleh dari akun dan perjanjian OpenAI pelanggan tersebut saat ini. Jangan memperkirakan tagihan bulanan dengan mengalikan judul media sosial dengan jumlah percakapan yang ditebak. Pemakaian token berubah sesuai panjang prompt, dokumen yang diambil, panjang keluaran, percobaan ulang, pemanggilan alat, dan pemeriksaan pagar pengaman.
Buat tabel biaya sebelum pilot. Masukkan biaya API input dan output, waktu engineering, pemantauan, penyimpanan log, biaya integrasi, peninjauan layanan pelanggan, serta biaya dari kesalahan. Lalu bandingkan total itu dengan nilai tugas yang diperbaiki. Respons cepat lebih berarti bagi prospek masuk bernilai tinggi atau checkout yang tersendat dibanding ringkasan internal yang baru diperlukan esok pagi.
Kapasitas juga penting. Pratinjau terbatas dapat mempunyai batas pemakaian, akses yang berubah, atau performa yang berbeda saat beban tinggi. Bisnis perlu menyiapkan tingkatan cadangan dan cadangan manusia. Pelanggan tidak boleh ditinggalkan dengan layanan rusak karena tingkatan eksperimental mencapai batas.
Ada pula pertanyaan mata uang yang tidak boleh diabaikan. Tagihan API penyedia besar umumnya dalam dolar AS dan dikonversi dengan kurs yang berlaku saat penagihan. Usaha kecil yang membukukan rupiah perlu memodelkan paparan itu secara eksplisit, bukan baru menyadarinya pada tagihan pertama. Tabel biaya yang tampak masuk akal pada satu kurs dapat berbeda satu kuartal kemudian. Menyisakan margin untuk perubahan kurs adalah bagian dari anggaran pilot yang jujur, bukan catatan tambahan yang bisa dilewatkan.
🧪 Pilot empat minggu yang menghasilkan bukti
Pilot yang berguna tidak harus berbiaya besar. Pilot membutuhkan cakupan yang stabil. Mulailah dari satu alur kerja dengan volume cukup untuk diukur dan konsekuensi rendah jika sistem melakukan handoff. Pertanyaan ketersediaan produk, pra-penyaringan janji temu, atau perutean permintaan dukungan umum adalah kandidat lebih baik daripada sengketa pembayaran atau nasihat medis.
Sebelum pilot dimulai, tuliskan batasan yang wajib dipatuhi asisten:
- Jawab hanya dari katalog produk, dokumen kebijakan, atau FAQ yang sudah disetujui, jangan dari ingatan atau tebakan.
- Jangan pernah mengonfirmasi pembayaran, menerbitkan pengembalian dana, atau menjanjikan tanggal pengiriman tanpa pemeriksaan sistem.
- Alihkan ke manusia segera bila pertanyaan berada di luar daftar topik yang ditentukan atau pelanggan meminta manusia.
- Catat setiap percakapan agar peninjau dapat mengaudit akurasi setelahnya.
Pada minggu pertama, tulis data dasar. Ukur median waktu balasan pertama, waktu penyelesaian, persentase chat yang dialihkan ke manusia, kontak berulang, chat yang ditinggalkan, dan kesalahan yang ditemukan saat peninjauan. Simpan sampel permintaan nyata setelah menghapus informasi yang tidak diperlukan. Tentukan sumber jawaban dan nama staf yang memilikinya.
Pada minggu kedua, jalankan tingkatan yang ada dengan prompt tetap dan proses tinjau sederhana. Pada minggu ketiga, bila tingkatan lebih cepat benar-benar tersedia, jalankan sampel sebanding melalui tingkatan itu tanpa mengubah kebijakan atau basis pengetahuan. Pada minggu keempat, bandingkan hasil. Jangan membandingkan minggu liburan yang ramai dengan hari kerja sepi lalu menyebut selisihnya sebagai performa model.
Aturan keputusan harus ditulis sebelum peluncuran. Misalnya, lanjut hanya jika waktu respons pertama turun sejumlah yang ditetapkan, akurasi bertahan di atas ambang tim, tidak ada pelanggaran kebijakan berisiko tinggi, dan biaya tambahan per permintaan yang selesai masih dapat diterima. Jika tidak ada aturan yang terpenuhi, berhenti. Pilot yang dihentikan dengan catatan bersih tetap merupakan bukti berguna, bukan kegagalan.
🚫 Hal yang tidak dibuktikan pengumuman ini
Pengumuman ini tidak membuktikan bahwa GPT-5.6 Sol lebih akurat dalam mode Ultrafast. Pengumuman ini tidak membuktikan angka 750 token per detik akan dirasakan setiap pengguna. Ini tidak membuktikan agen layanan pelanggan akan menyelesaikan lebih banyak tiket, toko e-commerce akan mengonversi lebih banyak pembeli, atau model dapat dipercaya untuk keputusan sensitif.
Pengumuman ini juga tidak menyelesaikan persaingan yang lebih luas di antara penyedia AI. Anthropic, Google, dan penyedia lain mengembangkan gabungan kemampuan model, harga, latensi, dan alat mereka sendiri. Usaha kecil tidak perlu meramal pemenang. Usaha kecil membutuhkan antarmuka yang bisa diuji, cara memindahkan pengetahuan yang sudah disetujui, dan catatan yang menunjukkan apakah alat itu benar-benar membantu.
Perlakukan setiap angka “x kali lebih cepat” di pasar ini seperti stiker efisiensi bahan bakar. Itu pengukuran laboratorium dalam kondisi tertentu, berguna untuk perbandingan, tetapi bukan jaminan hasil pada rute tertentu. Klaim 14x diukur dalam beban, bentuk prompt, dan kondisi tertentu. Beban kerja Anda memiliki hambatannya sendiri, dan sebagian hambatan seperti API internal lambat atau antrean persetujuan manual sama sekali tidak berkaitan dengan model. Tanyakan kondisi di balik angka judul sebelum menjadikannya perkiraan hasil Anda sendiri.
Ada batas privasi juga. Inference yang lebih cepat tidak mengubah pertanyaan dasar tentang data apa yang keluar dari bisnis dan ketentuan apa yang berlaku. Sebelum menghubungkan chat pelanggan, faktur, atau dokumen internal ke API mana pun, baca kontrol data saat ini, pilihan retensi, ketentuan kontrak, dan aturan akses. Hapus informasi sensitif bila tidak diperlukan untuk tugas. Jangan memasukkan kredensial produksi ke dalam prompt atau dokumen bersama.
Kutipan itu menjelaskan arah, bukan hasil yang sudah diperoleh pedagang tertentu. Respons yang tepat adalah tertarik lalu memverifikasi. Minta detail akses, ketentuan teknis, harga, dan keluaran terukur dari akun nyata yang akan menjalankan pekerjaan.
✅ Keputusan praktis untuk UMKM Indonesia
Sebagian besar UMKM Indonesia sebaiknya memasukkan Ultrafast ke daftar pantauan, bukan daftar pengadaan. Tingkatan ini adalah infrastruktur API pratinjau terbatas. Belum ada pengumuman peluncuran umum di Indonesia, tidak ada sakelar aplikasi konsumen untuk diaktifkan, dan belum ada bukti bahwa biaya percakapan bisnis biasa menjadi lebih rendah.
Bisnis yang patut bersiap sekarang adalah bisnis dengan alur kerja API yang sudah ada dan masalah latensi yang terukur. Antrean dukungan langsung, asisten suara, proses insiden pengembang, atau arus commerce bervolume tinggi mungkin layak mengajukan akses saat jangkauan diperluas. Bahkan dalam kondisi itu, pengujian harus melindungi data pelanggan, membatasi kewenangan otomatis, mempertahankan cadangan manusia, dan membandingkan hasil tugas penuh, bukan hanya kecepatan token.
Bagi yang lain, pekerjaan segera memang tidak glamor tetapi tahan lama. Bersihkan data produk. Putuskan pertanyaan mana yang boleh dijawab asisten. Buat eskalasi terlihat. Lacak kesalahan. Pertahankan manusia yang bertanggung jawab atas pembayaran, pengiriman, pengembalian dana, dan pengecualian. Saat akses model lebih cepat tiba di pasar, fondasi ini akan menentukan apakah teknologi menjadi perbaikan layanan yang berguna atau hanya cara lebih cepat untuk membuat kesalahan yang sama.
Tidak ada yang mengharuskan bisnis menunggu pasif. Bisnis dapat menulis aturan eskalasi, mendokumentasikan FAQ, dan menyusun rencana pengukuran bulan ini dengan akses model apa pun yang sudah dimiliki, baik akun API Standard maupun langganan chat konsumen. Ketika tingkatan lebih cepat akhirnya terbuka lebih luas, bisnis yang sudah memiliki data bersih dan aturan jelas dapat menangkap manfaatnya dalam hitungan hari. Bisnis yang masih membersihkan katalog akan memakai waktu yang sama untuk membetulkan kesalahan yang sebenarnya dapat dihindari.
Sumber: OpenAI, “Previewing Ultrafast mode” dan “OpenAI partners with Cerebras,” Januari dan Agustus 2026; laporan TechCrunch, 9to5Mac, India Today, serta The Next Web tentang pratinjau; Times of India tentang Anthropic Fast Mode. Diakses 14 Agustus 2026.
Sumber video resmi: OpenAI di YouTube, “Previewing Ultrafast mode: GPT-5.6 Sol at up to 14X the speed.”