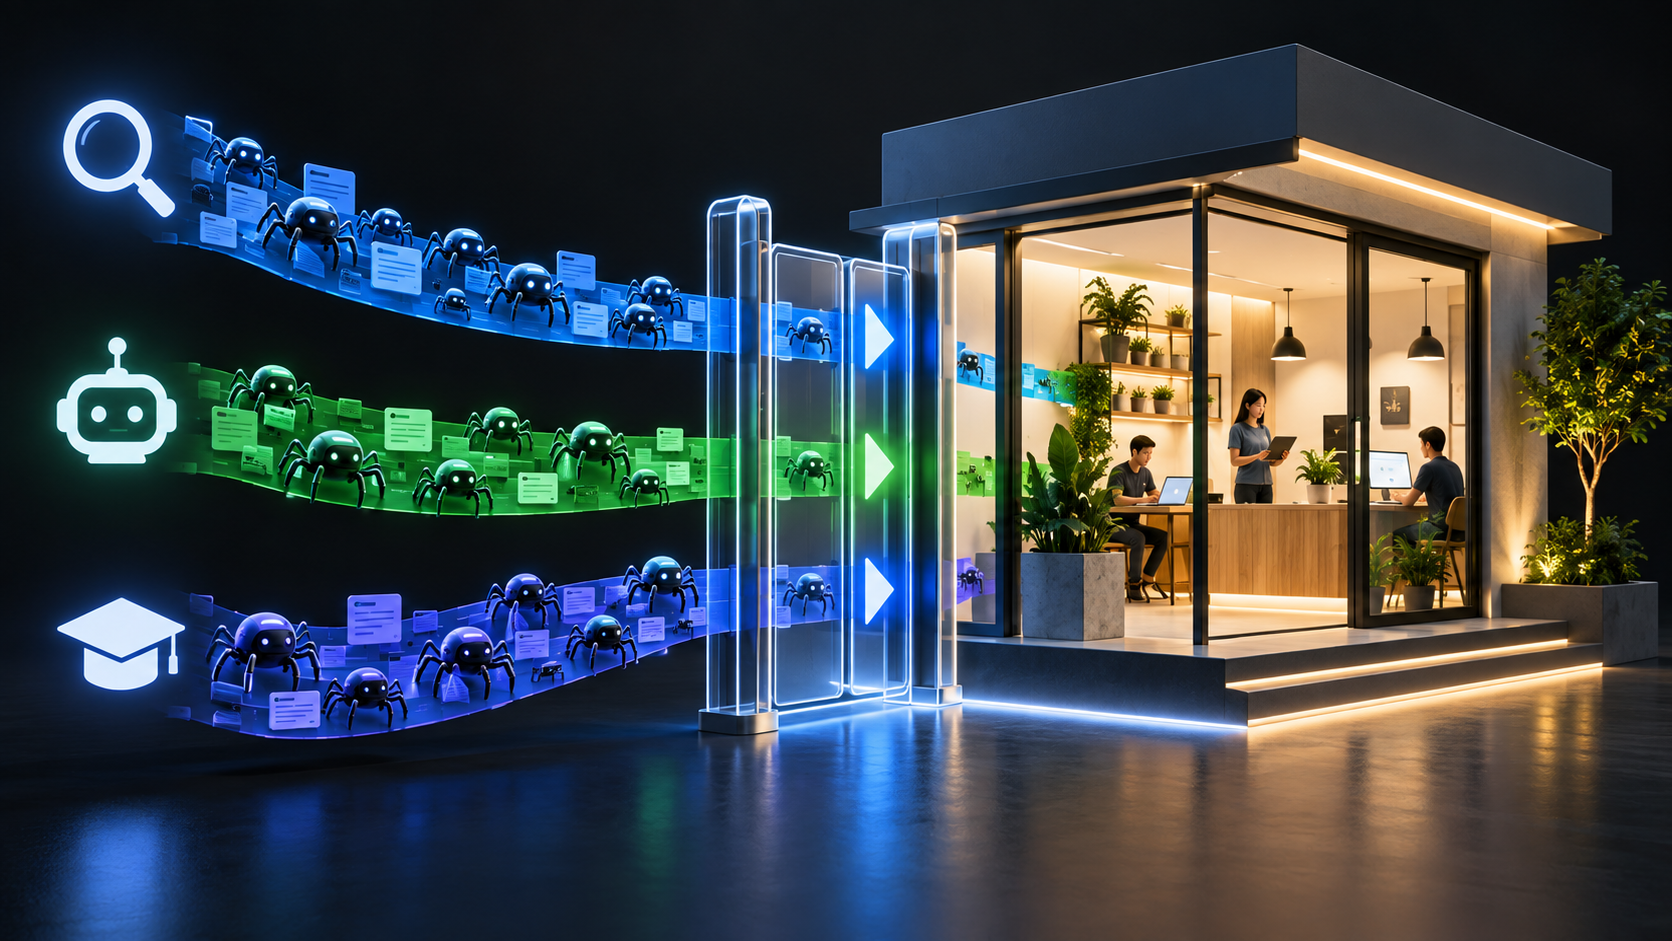
Sebelum menambah schema markup, mengejar kata kunci baru, atau membayar audit SEO, pemilik situs perlu menjawab pertanyaan yang lebih mendasar: bot mana yang boleh mengambil isi situs, untuk tujuan apa, dan halaman mana yang bernilai berbeda bagi bisnis. Jawabannya tidak bisa lagi diringkas menjadi “izinkan Google, blokir AI”. Satu domain dapat menerima perayap pencarian, agen yang datang atas permintaan pengguna, pengumpul data pelatihan, pemantau keamanan, dan scraper yang menyamar sebagai semuanya.
Bagi toko lokal, studio desain, klinik, sekolah kursus, atau penerbit kecil di Indonesia, kebijakan ini bukan urusan perusahaan besar saja. Deskripsi jasa, katalog, artikel panduan, daftar harga, foto portofolio, dan halaman lowongan adalah aset yang mudah diambil dalam skala besar. Sebagian kunjungan mesin membantu orang menemukan bisnis. Sebagian lain menyalin beban server atau memindahkan nilai halaman ke produk lain. Tanpa keputusan tertulis, tim biasanya baru bereaksi setelah log penuh lalu lintas aneh atau setelah isi situs muncul tanpa konteks di jawaban AI.
🤖 Pengunjung situs yang tidak menjelajah seperti manusia
Manusia umumnya membuka halaman karena punya niat yang cukup jelas: membandingkan harga, mencari alamat, membaca panduan, atau menghubungi penjual. Perayap bekerja berbeda. Ia meminta banyak URL secara otomatis, mengikuti tautan, dan menyimpan hasilnya menurut aturan operatornya. Dari sudut server, semuanya tampak sebagai permintaan HTTP. Dari sudut bisnis, dampaknya bisa sangat berbeda.
Kategori pertama adalah perayap pencarian. Tugas utamanya menemukan dan memperbarui halaman untuk indeks mesin pencari, lalu menampilkan tautan dan cuplikan pada hasil pencarian. Situs UMKM sering masih bergantung pada jalur ini untuk mendatangkan calon pelanggan yang memang sedang mencari layanan. Memblokirnya secara gegabah dapat membuat halaman baru lebih lambat ditemukan atau pembaruan katalog tidak tercermin.
Kategori kedua adalah agen. Agen dapat mengunjungi situs untuk menjawab permintaan pengguna, misalnya merangkum informasi layanan, mengecek ketersediaan, atau membandingkan produk. Kunjungan semacam ini tidak selalu berarti isi situs masuk ke set pelatihan model. Namun, agen tetap dapat mengonsumsi halaman, mengabaikan urutan pembelian yang dirancang bisnis, dan membawa jawaban ke antarmuka lain. Untuk toko yang mengandalkan iklan pada halaman panduan, ini adalah pertimbangan komersial yang nyata.
Kategori ketiga adalah perayap pelatihan. Tujuannya mengumpulkan materi untuk melatih atau menyempurnakan model. Keputusan terhadap kategori ini tidak sama dengan keputusan SEO. Ada pula crawler campuran, yaitu identitas yang memiliki lebih dari satu penggunaan. Inilah bagian yang membuat daftar blokir sederhana rapuh: nama user agent belum tentu menerangkan semua cara konten digunakan setelah diambil.
Pada 1 Juli 2026, Cloudflare memperkenalkan pilihan pengelolaan lalu lintas AI menurut tiga penggunaan besar: Search, Agent, dan Training. Untuk Search dan Agent, pilihan yang diumumkan adalah mengizinkan, memblokir pada halaman yang menayangkan iklan, atau memblokir di semua halaman. Pemisahan ini berguna sebagai kerangka berpikir, bahkan bila situs tidak memakai Cloudflare. Pertanyaan yang perlu dijawab bukan “apakah AI baik atau buruk”, melainkan “akses apa yang kita setujui pada jenis halaman tertentu”.
Jangan menyamakan deklarasi user agent dengan identitas terverifikasi. Siapa pun dapat mengirim header yang mengaku sebagai bot terkenal. Jika tim hendak memberi pengecualian pada tingkat firewall atau CDN, verifikasi harus memakai prosedur penyedia bot, misalnya pemeriksaan DNS terbalik dan maju atau rentang IP yang mereka dokumentasikan. Header teks saja tidak cukup untuk membuka jalan ke seluruh situs.
Perbedaan tujuan juga penting saat membaca analitik. Lonjakan request tidak otomatis serangan, dan crawler yang patuh tidak otomatis menguntungkan. Periksa URL yang diminta, kecepatan, kode respons, IP, user agent, serta apakah permintaan mencapai halaman berat seperti pencarian internal, PDF, keranjang, atau endpoint API. Kebijakan yang baik memberi tim cara membedakan perayap yang disambut, yang dibatasi, dan yang harus ditahan.
🧭 Mulai dari keputusan, bukan daftar bot
Daftar bot cepat usang. Penyedia dapat mengganti nama, menambah produk, menggabungkan fungsi, atau mengoperasikan beberapa user agent. Kebijakan yang dimulai dari puluhan nama bot membuat tim sibuk memelihara daftar tanpa pernah sepakat atas tujuan bisnis. Mulailah dengan keputusan yang dapat dipahami pemilik, editor, pemasaran, dan pengembang.
Buat matriks kecil dengan baris berupa jenis halaman dan kolom berupa penggunaan. Jenis halaman yang lazim untuk bisnis kecil antara lain halaman beranda dan layanan, artikel publik, katalog produk, halaman dengan iklan, halaman pelanggan setelah masuk, dokumen unduhan, pencarian internal, serta API. Untuk setiap baris, putuskan apakah pencarian biasa boleh, agen boleh, dan pelatihan boleh. Tambahkan alasan singkat dan pemilik keputusan.
Contoh yang masuk akal untuk bengkel komputer di Makassar: halaman layanan dan lokasi boleh diindeks mesin pencari karena keduanya membantu pelanggan menemukan toko. Artikel panduan perawatan mungkin boleh diakses perayap pencarian tetapi penggunaan pelatihan ditolak sampai pemilik memutuskan lain. Katalog dengan harga yang sering berubah dapat tetap terbuka untuk pencarian, sedangkan endpoint stok dan keranjang wajib dibatasi untuk alasan teknis, bukan karena label AI. Halaman akun pelanggan harus berada di balik autentikasi, tanpa perlu mengandalkan robots.txt.
Kebijakan tidak harus seragam untuk setiap domain atau subdomain. Situs utama, pusat bantuan, toko, dan dokumentasi API mungkin punya nilai serta risiko yang berbeda. Jika dokumen publik memang dirancang agar mudah ditemukan, memblokir semua bot hanya karena khawatir pelatihan dapat mengorbankan manfaat yang sudah jelas. Sebaliknya, membiarkan semua akses karena takut kehilangan peringkat juga bukan keputusan, melainkan kebiasaan lama.
Tulis keputusan dengan bahasa yang dapat diuji. Kalimat “kami ingin tetap terlihat di internet” terlalu kabur. Kalimat “izinkan crawler Google Search pada halaman publik, jangan izinkan crawling pelatihan pada artikel dan PDF, lindungi akun, checkout, pencarian internal, dan API dengan kontrol akses” dapat diterjemahkan menjadi konfigurasi, diuji, lalu ditinjau ulang.
Batas waktu perlu masuk ke matriks. Harga promosi, jadwal acara, atau inventaris mungkin terbuka saat kampanye berjalan dan berubah setelahnya. Tetapkan siapa yang berwenang mengubah keputusan, kapan perubahan berlaku, dan bagaimana rollback dilakukan. Tim kecil tidak membutuhkan komite khusus. Satu pemilik bisnis sebagai penentu nilai konten, satu orang teknis sebagai pelaksana, dan satu catatan perubahan sudah jauh lebih aman daripada pengaturan yang diwariskan tanpa konteks.
Tinjau juga tujuan yang saling bertabrakan. Tim pemasaran mungkin ingin halaman mudah ditemukan, redaksi ingin melindungi artikel premium, dan tim operasional ingin mengurangi beban server. Konflik itu tidak diselesaikan oleh satu baris Disallow. Ia perlu keputusan prioritas. Ketika prioritas tertulis, pengembang tidak dipaksa menebak apakah masalah utama adalah visibilitas, biaya bandwidth, lisensi, atau privasi.
📜 robots.txt masih berguna, tetapi bukan gembok
Robots Exclusion Protocol memberi situs cara menyatakan bagian mana yang boleh atau tidak boleh diakses oleh crawler. RFC 9309 menetapkan bentuk dasarnya, termasuk kelompok user-agent dan aturan allow atau disallow yang merujuk pada awal path. File itu ditempatkan di akar origin, misalnya https://contoh.id/robots.txt. Ia bukan file global untuk seluruh internet: protokol, host, dan port yang berbeda dapat memiliki kebijakan berbeda.
Fungsi praktis robots.txt tetap penting. Ia memberi arahan kepada crawler yang mematuhinya, membantu mengurangi crawling pada area yang tak perlu, dan menjadi artefak kebijakan yang mudah diperiksa. Google menjelaskan bahwa robots.txt terutama digunakan untuk mengatur URL yang dapat diakses crawler dan menghindari beban request, bukan untuk menjauhkan halaman dari Google. Jadi, jangan memperlakukan Disallow sebagai pengunci ruang rahasia.
URL yang dilarang dirayapi masih dapat diketahui dari tautan luar atau sumber lain. Jika targetnya menghapus halaman dari hasil Google, gunakan noindex pada halaman yang tetap dapat dirayapi, atau lindungi halaman dengan autentikasi bila memang tidak boleh diakses publik. Menaruh data pelanggan, invoice, draf kontrak, atau file ekspor di URL terbuka lalu menambahkan Disallow adalah kesalahan desain akses. Konten sudah terbuka bagi siapa pun yang tahu atau menebak URL-nya.
Struktur file juga perlu diperlakukan dengan hati-hati. Aturan untuk semua crawler tidak selalu berarti aturan yang paling spesifik akan berperilaku seperti harapan manusia. RFC 9309 menjelaskan pengelompokan menurut product token user agent dan pencocokan path. Dokumentasi tiap penyedia tetap perlu dibaca untuk token dan perilaku produknya. Jangan menyisipkan sintaks dari generator acak tanpa memeriksa file yang benar-benar tersaji dari origin.
Versi sederhana dapat membantu memisahkan niat, tetapi bukan resep universal:
User-agent: Googlebot
Allow: /

User-agent: Google-Extended
Disallow: /

User-agent: *
Disallow: /akun/
Disallow: /checkout/
Disallow: /cari/
Contoh itu mempertahankan akses Googlebot untuk pencarian, sambil menyatakan preferensi terpisah untuk Google-Extended dan menutup path operasional dari crawler umum. Ia tidak otomatis mencakup penyedia lain, tidak mengamankan path, dan tidak membuktikan bahwa setiap pihak akan mematuhi preferensi. Perlakukan sebagai ilustrasi struktur, lalu sesuaikan dengan dokumentasi crawler yang benar-benar relevan.
Bila memakai CMS, pastikan siapa yang memiliki robots.txt. Sebagian platform menghasilkan file otomatis atau menimpanya saat pembaruan tema dan plugin. Uji URL publiknya setelah deploy. Periksa pula apakah CDN menyajikan versi lama dari cache, apakah subdomain toko memakai origin lain, dan apakah aturan firewall justru bertentangan dengan file. File yang bagus di repositori tidak ada artinya jika server menyajikan versi berbeda.
🔎 Pisahkan penemuan pencarian dari pemakaian ulang AI
Kesalahan mahal dalam kebijakan crawler adalah menganggap semua crawling sebagai SEO. Pencarian, pelatihan, dan penggunaan konten sebagai masukan jawaban AI adalah penggunaan yang berbeda. Cloudflare membedakan Search, Agent, dan Training; Content Signals Policy mereka juga membedakan search, ai-input, dan ai-train. Istilah dan cakupan setiap produk perlu dibaca sesuai dokumentasinya, tetapi pemisahan konsepnya layak dipakai dalam rapat kebijakan.
Untuk bisnis yang mengandalkan traffic organik, pertahankan keputusan eksplisit terhadap crawler pencarian. Jangan memblokir Googlebot hanya untuk mengejar opt-out AI. Google menyediakan token Google-Extended sebagai kontrol untuk penggunaan konten Google dalam pelatihan model Gemini dan grounding untuk layanan Gemini serta Vertex AI tertentu. Google menyatakan token tersebut tidak memengaruhi inklusi di Google Search dan bukan sinyal peringkat Search. Artinya, keputusan terhadap Google Search dan penggunaan AI yang dicakup Google-Extended dapat dipisahkan.
Namun, jangan membuat klaim lebih besar daripada dokumentasi. Google-Extended bukan identitas HTTP crawler tersendiri yang dapat dicari begitu saja di log server. Anda mungkin tetap melihat request Googlebot. Karena itu, mengandalkan blok IP khusus “Google-Extended” adalah pendekatan yang salah sasaran. Periksa robots.txt yang diterbitkan, kebijakan produk Google terbaru, dan konfigurasi crawler Google Search secara terpisah.
Pemisahan serupa dibutuhkan pada penyedia lain, tetapi token dan janji kepatuhan tidak identik. Ada operator yang menerbitkan crawler pencarian dan crawler pelatihan berbeda. Ada yang menggunakan satu identitas untuk beberapa fungsi. Ada pula sistem yang datang atas perintah pengguna. Jangan menyalin satu aturan Google lalu menganggapnya berlaku untuk seluruh ekosistem AI.
Cloudflare pada Juli 2026 menawarkan pengaturan kategori agar pemilik situs dapat memilih perlakuan untuk Search, Agent, dan Training. Pada halaman beriklan, opsi memblokir agen atau perayap tertentu dapat masuk akal bila pendapatan bergantung pada tampilan halaman oleh manusia. Tetapi sebuah situs kursus yang memperoleh prospek dari artikel gratis mungkin justru menerima akses pencarian dan agen pada artikel tertentu. Kebijakan yang tepat mengikuti model pendapatan dan tujuan halaman, bukan tren umum.
Ketika menggunakan sinyal tambahan di robots.txt, bedakan antara preferensi dan penegakan. Cloudflare menyebut Content Signals sebagai cara menyatakan preferensi penggunaan konten setelah diakses. Sinyal tersebut tidak menciptakan blok teknis dengan sendirinya. Untuk risiko yang benar-benar perlu dicegah, seperti scraping agresif atau akses ke endpoint mahal, padukan pernyataan kebijakan dengan kontrol server, rate limit, WAF, autentikasi, dan pemantauan.
Situs juga tidak perlu memilih antara “membuka semua” dan “menutup semua”. Kebijakan dapat mengatakan pencarian boleh untuk artikel publik, penggunaan pelatihan ditolak, agen dibatasi pada halaman noniklan, dan akses otomatis ke endpoint pencarian dibatasi. Kejelasan seperti ini lebih mudah dipertahankan daripada satu larangan besar yang kemudian dipenuhi pengecualian tak terdokumentasi.
🧾 Tentukan batas komersial untuk setiap jenis halaman
Nilai komersial tidak hanya berada di balik paywall. Halaman yang menghasilkan prospek, mengandung data harga hasil riset, menampilkan portofolio, atau membawa trafik iklan dapat memiliki alasan bisnis untuk diperlakukan berbeda. Sebelum memasang aturan, petakan apa yang sebenarnya dipertaruhkan jika halaman dibaca otomatis dalam skala besar atau jawabannya diberikan di luar situs.
Halaman layanan dasar biasanya adalah kandidat kuat untuk tetap terbuka bagi pencarian. Alamat, jam buka, cakupan layanan, dan cara menghubungi bisnis membantu pengguna menemukan jawaban yang memang ingin disebarkan pemilik. Menutupnya dari crawler pencarian dapat lebih merugikan daripada melindungi apa pun. Pastikan halaman itu akurat, memiliki teks yang dapat dibaca, dan tidak bergantung seluruhnya pada gambar atau interaksi JavaScript yang rapuh.
Artikel editorial dan panduan memiliki keputusan yang lebih berlapis. Penerbit yang hidup dari iklan dapat mempertimbangkan pembatasan untuk agen pada halaman beriklan, sejalan dengan kategori yang disediakan Cloudflare. Penerbit berlangganan dapat memisahkan ringkasan publik dari isi penuh yang hanya tersedia setelah login. Bukan untuk “mengakali bot”, melainkan untuk menegakkan model akses yang berlaku bagi semua pihak.
Katalog produk perlu dibedakan dari data operasional. Deskripsi produk dan harga publik boleh ditemukan, tetapi stok real-time, diskon khusus member, kuota kelas, dan aturan pengiriman internal sebaiknya berada pada endpoint yang memerlukan kontrol akses atau pembatasan request. Robots.txt dapat mengurangi crawling yang tidak diinginkan pada path tertentu, tetapi ia tidak menggantikan autentikasi API, validasi otorisasi, atau rate limit.
Dokumen PDF sering terlupakan. Brosur publik mungkin boleh diindeks. Materi pelatihan berbayar, proposal klien, lembar kerja internal, atau dokumen yang memuat data pribadi tidak boleh bergantung pada URL yang sulit ditebak. Simpan di area dengan autentikasi dan hak akses. Untuk berkas publik bernilai tinggi, putuskan secara eksplisit apakah hanya penemuan pencarian yang diizinkan atau juga penggunaan lain yang dinyatakan oleh penyedia.
Tulis juga respons saat pihak yang sah ingin bekerja sama. Jika perusahaan data atau penyedia AI ingin lisensi konten, kontak yang jelas lebih berguna daripada blok yang membingungkan. Halaman lisensi singkat dapat menyebut email bisnis, jenis materi yang dapat dinegosiasikan, dan bahwa izin tertulis diperlukan untuk penggunaan yang tidak dicakup lisensi publik. Itu bukan pengganti nasihat hukum, tetapi membuat jalur komersial dan operasional lebih tertata.
Hindari menetapkan batas berdasarkan rasa takut yang tidak terukur. Jika alasan memblokir adalah biaya, ukur halaman mana yang berat dan bot mana yang memicunya. Jika alasan adalah hak cipta, identifikasi konten yang benar-benar orisinal atau berlisensi terbatas. Jika alasan adalah privasi, perbaiki kontrol akses lebih dulu. Setiap alasan menghasilkan alat yang berbeda.
🛠️ Bangun tumpukan kebijakan kecil yang bisa dirawat tim
Tidak ada satu pengaturan yang menyelesaikan seluruh masalah. Susun tumpukan kecil dengan fungsi yang jelas agar orang berikutnya tidak perlu menerka. Lapisan pertama adalah inventaris dan keputusan halaman. Lapisan kedua adalah robots.txt untuk menyatakan aturan crawling kepada pihak yang patuh. Lapisan ketiga adalah kontrol teknis yang benar-benar menegakkan batas, seperti autentikasi, WAF, rate limiting, aturan CDN, dan pembatasan endpoint.
Lapisan keempat adalah metadata dan kontrol indeks untuk tujuan pencarian. Jika halaman harus tidak muncul di hasil pencarian, gunakan mekanisme indeks yang sesuai, bukan Disallow sebagai satu-satunya cara. Lapisan kelima adalah observabilitas: log, dashboard CDN, notifikasi lonjakan request, dan catatan perubahan. Tanpa itu, tim tak tahu apakah aturan berdampak atau justru memblokir crawler yang dibutuhkan.
Untuk situs kecil, dokumentasi cukup berupa satu halaman di repositori atau wiki internal. Cantumkan domain dan subdomain yang dicakup, tabel keputusan per jenis halaman, lokasi konfigurasi, daftar pengecualian, tanggal peninjauan terakhir, serta kontak pemilik. Simpan salinan robots.txt yang diterbitkan dan tautkan perubahan WAF ke tiket atau commit. Jangan mengandalkan ingatan admin yang mungkin pindah pekerjaan.
Uji perubahan seperti pengubahan fitur checkout. Dari jaringan luar, ambil robots.txt yang aktif. Periksa kode respons dan cache. Jalankan pengujian URL untuk beberapa crawler dan path penting bila alat penyedia tersedia. Amati apakah halaman publik tetap dapat dirayapi oleh mesin pencari yang diizinkan, apakah endpoint internal memberi respons yang benar, dan apakah ada lonjakan 403 atau 429 yang memengaruhi pengguna nyata.
Jangan memasang blok berbasis user agent semata untuk serangan berat. Pelaku dapat mengganti header dalam hitungan detik. Gunakan gabungan sinyal yang tersedia di CDN atau WAF, dan terapkan batas pada perilaku: request terlalu cepat, akses berulang ke path mahal, pola enumerasi, atau kegagalan autentikasi. Bila memberi kelonggaran pada bot terverifikasi, dokumentasikan metode verifikasinya.
Pilih interval peninjauan yang realistis, misalnya setiap kuartal dan setiap kali situs mengubah model bisnis, pindah CDN, meluncurkan API, atau mulai memonetisasi halaman dengan iklan. Periksa perubahan dokumentasi penyedia karena nama crawler dan cakupan kontrol dapat berubah. Kebijakan yang dirawat lebih berharga daripada file besar yang tak disentuh dua tahun.
♿ Jangan merusak web bagi manusia saat memblokir mesin
Blokir bot yang buruk sering dirancang dari sudut sistem saja: CAPTCHA di setiap halaman, challenge yang menghalangi pembaca, JavaScript wajib untuk membaca informasi dasar, atau rate limit yang menghukum pengguna dengan koneksi bersama. Langkah seperti itu dapat mengurangi scraping tertentu sambil membuat situs lebih sulit dipakai oleh pelanggan, pengguna perangkat bantu, dan orang dengan jaringan lambat.
WCAG 2.2 dari W3C mencakup rekomendasi untuk membuat konten web lebih aksesibel. Dalam praktik kebijakan crawler, prinsipnya sederhana: pertahanan tidak boleh menjadikan alur utama mustahil dipakai manusia. Formulir kontak, katalog, pembelian, dan akses bantuan harus tetap dapat dioperasikan dengan keyboard, memiliki label yang jelas, memberi pesan kesalahan yang dapat dipahami, dan tidak bergantung pada teka-teki visual tanpa alternatif.
CAPTCHA adalah contoh yang perlu kehati-hatian. Bila benar-benar diperlukan pada titik berisiko, sediakan opsi yang dapat diakses dan jangan letakkan pada setiap pembaca artikel. Tinjau dampaknya pada pembaca yang memakai pembaca layar, pengguna keyboard, orang dengan disabilitas kognitif, serta pengunjung yang menolak skrip pelacak. Lebih baik menempatkan perlindungan kuat pada endpoint bernilai tinggi seperti pendaftaran, login, pencarian mahal, atau checkout daripada mengganggu seluruh situs.
Pastikan respons blok tidak membocorkan data dan tetap berguna. Halaman 403 atau 429 untuk pengguna nyata perlu menjelaskan apa yang terjadi tanpa menyalahkan pengunjung. Sertakan jalur bantuan yang dapat diakses bila pelanggan sah terkunci. Untuk aplikasi, gunakan status HTTP yang tepat dan dokumentasi API, bukan halaman challenge yang tak dapat diproses integrasi resmi.
Uji dengan skenario manusia, bukan hanya alat keamanan. Coba menyelesaikan pembelian dari ponsel jaringan lambat. Navigasikan halaman dengan keyboard. Periksa pembaca layar pada formulir penting. Bandingkan request dari pengunjung biasa dengan bot yang ingin dibatasi. Jika konfigurasi baru meningkatkan tiket dukungan atau penolakan pembayaran, kebijakan perlu disesuaikan meski dashboard keamanan terlihat “lebih bersih”.
Aksesibilitas juga menguntungkan pemeliharaan. Halaman dengan struktur HTML semantik, tautan jelas, dan konten inti yang tersedia tanpa trik interaksi biasanya lebih mudah diakses manusia dan lebih mudah dipahami crawler pencarian yang memang diizinkan. Ini bukan alasan untuk membuka semua bot. Ini alasan untuk tidak menukar kegunaan situs dengan penghalang yang kasar.
⚖️ Batas, hal yang belum pasti, dan keputusan yang tidak bisa dibuat pengaturan
Tidak semua pertanyaan dapat dijawab lewat konfigurasi. robots.txt adalah protokol komunikasi yang dipatuhi crawler yang memilih untuk mematuhinya. Ia tidak menghentikan pihak yang sengaja mengabaikan arahan, tidak menghapus salinan yang sudah diambil, dan tidak menetapkan kontrak lisensi secara otomatis. WAF dan rate limit menambah penegakan teknis, tetapi juga tidak menyelesaikan sengketa hak cipta, kontrak, atau yurisdiksi.
Penyedia AI juga berubah. Definisi “grounding”, “agent”, “search summary”, atau “training” mungkin berbeda antarproduk dan dapat diperbarui. Jangan menulis kebijakan publik yang menjanjikan hasil yang tidak dapat Anda verifikasi, misalnya bahwa konten “pasti tidak pernah digunakan AI”. Nyatakan tindakan yang Anda ambil: preferensi robots.txt, akses yang diblokir, area yang diautentikasi, dan kanal lisensi.
Crawler campuran membutuhkan perhatian khusus. Cloudflare sendiri menyoroti masalah bot yang mencampur Search, Agent, dan Training di bawah satu user agent. Jika satu identitas diperlukan untuk pencarian namun perilaku lain tidak Anda setujui, pilihan teknis dapat menjadi kasar. Memblokirnya dapat berpengaruh pada penemuan pencarian. Mengizinkannya dapat memperluas akses yang tidak diinginkan. Di titik ini, dokumentasi operator, transparansi, kontrak, dan pertimbangan bisnis lebih penting daripada daftar aturan yang terlihat rapi.
Keputusan hukum juga tidak dapat dibuat oleh tombol CDN. Apakah kutipan, caching, ekstraksi basis data, pemakaian ulang konten berlisensi, atau pelatihan pada materi tertentu dibolehkan bergantung pada fakta dan hukum yang relevan. Jika situs menerbitkan karya pihak lain, terikat perjanjian eksklusif, mengelola data pribadi, atau ingin menjual lisensi konten, libatkan penasihat hukum yang memahami konteksnya. Tim web dapat menyediakan bukti teknis, bukan menetapkan kesimpulan hukum sendiri.
Ada batas operasional yang sama pentingnya. Jangan pernah memblokir seluruh negara, seluruh ASN, atau seluruh traffic otomatis hanya karena satu insiden tanpa melihat dampak. Integrasi pembayaran, uptime monitor, cache, mesin pencari, dan alat internal dapat ikut terkena. Mulai dari path dan pola yang bermasalah, uji, pantau, lalu perluas jika bukti mendukung.
Ketidakpastian bukan alasan untuk diam. Ia alasan untuk memilih kebijakan yang reversibel. Catat asumsi, terapkan perubahan kecil, tetapkan tanggal tinjau ulang, dan sediakan rollback. Bila kebijakan menurunkan traffic organik atau mengganggu pelanggan, tim harus dapat menemukan siapa yang mengubah apa dan mengembalikan kondisi tanpa debat panjang.
✅ Keputusan praktis untuk situs kecil
Situs kecil tidak perlu mengejar setiap nama bot yang muncul di media sosial. Mulailah dalam satu sesi kerja singkat. Inventaris halaman publik, halaman bernilai komersial, area privat, dan endpoint mahal. Tandai siapa pemilik konten serta siapa yang dapat mengubah CDN atau hosting. Setelah itu, pilih sikap terhadap Search, Agent, dan Training untuk masing-masing kelompok halaman.
Gunakan urutan kerja berikut agar keputusan tidak berhenti sebagai dokumen:
- Pastikan halaman akun, checkout, dashboard, file pelanggan, dan API sensitif memang memerlukan autentikasi. Hapus asumsi bahwa robots.txt melindunginya.
- Biarkan crawler pencarian yang penting tetap dapat mengakses halaman publik jika pencarian organik masih menjadi saluran akuisisi. Uji crawler tersebut setelah perubahan.
- Terapkan preferensi yang terpisah untuk penggunaan AI bila operator menyediakan token atau kontrol yang terdokumentasi, termasuk Google-Extended bila kebijakan Anda menolak penggunaan yang dicakup token tersebut.
- Batasi endpoint berat dengan rate limit dan aturan WAF berdasarkan perilaku. Jangan mengandalkan nama user agent yang mudah dipalsukan.
- Untuk halaman beriklan atau konten bernilai lisensi, putuskan apakah akses agen perlu dibatasi dan sediakan kontak lisensi jika bisnis ingin menerima permintaan kerja sama.
- Ambil snapshot robots.txt, konfigurasi relevan, dan metrik sebelum perubahan. Periksa lagi setelah deploy pada domain dan subdomain yang benar.
- Tinjau kebijakan setiap kuartal atau ketika produk, model pendapatan, CMS, CDN, dan dokumentasi crawler berubah.
Jika tim hanya mampu melakukan satu hal minggu ini, tulis matriks satu halaman dan periksa robots.txt yang benar-benar tersaji di domain. Dari sana biasanya terlihat masalah yang selama ini tersembunyi: path privat ternyata publik, aturan wildcard menutup crawler yang dibutuhkan, CDN menyajikan file lama, atau tidak ada yang tahu mengapa bot tertentu dikecualikan.
SEO tetap penting. Kecepatan, struktur informasi, konten akurat, tautan internal, dan pengalaman pengguna masih memengaruhi apakah orang dapat menemukan dan memakai situs. Tetapi taktik SEO baru tidak memperbaiki keputusan akses yang belum pernah dibuat. Kebijakan crawler memberi batas awal: konten mana yang ingin ditemukan, penggunaan mana yang diterima, dan batas mana yang harus ditegakkan oleh sistem, bukan sekadar diminta dengan sopan.
Sources: https://blog.cloudflare.com/content-independence-day-ai-options/ | https://developers.google.com/search/docs/crawling-indexing/robots/intro | https://developers.google.com/search/docs/crawling-indexing/overview-google-crawlers | https://www.rfc-editor.org/rfc/rfc9309.html | https://www.w3.org/TR/WCAG22/


